
Практически всегда от моделей машинного обучения требуется указать их точность. Для расчета точности необходимо
1) обучить модель на тренировочном датасете
2) предсказать результаты на тестовом датасете
3) сравнить правильные данные с предсказанными
Данная процедура проста, но в зависимости от разбиения на обучающий датасет и тестовый датасет мы получим немного разные значения. И какой же результат более правильный?
Правильного нет, ведь точность классификатора само по себе понятие относительное. Но интуитивно понятно, что для лучшей оценки необходимо провести процедуру 1-2-3 как можно большее количество раз.
И вот как раз для оценки точности классификатора и придумали кросс-валидацию. Или K-fold cross-validation.
Идея проста, весь датасет делится на N частей. На каждой итерации N-1 часть идёт на train, и одна на test.
В sklearn для этого есть специальный метод cross_val_score:
import numpy as np from sklearn.model_selection import cross_val_score from sklearn.datasets import load_iris from sklearn.ensemble import RandomForestClassifier # воспользуемся известным датасетом для примера iris = load_iris() clf = RandomForestClassifier(n_estimators=30, random_state=42) # передаем классификатор, X, y и кол-во фолдов=5 res = cross_val_score(clf, iris[‘data’], iris[‘target’], cv=5) print(res) # [0.96666667 0.96666667 0.93333333 0.96666667 1. ] print(np.mean(res)) # 0.966
Как видим всё очень просто, по сравнению с train_test_split мы получим более точную оценку качества классификатора, т.к. провели эксперимент N раз (в нашем случае 5 раз).
Machine Learning. Урок №2. Кросс — валидация/Сross-validation
Да, пришлось потратить в 5 раз больше времени по сравнению с train_test_split, но когда данных не очень много — это оправдано.
Однако не всегда удаётся воспользоваться методом cross_val_score, например если хотим что-то ещё подсчитать в это время.
Для этого есть более гибкий метод KFold.
Kfold часто используют не только для оценки точности классификатора, но и например для контроля переобучения для классификатора.
Для многих моделей очень важно знать, в какой момент начинается переобучение. Таким образом можно обучить 10 классификаторов с контролем переобучения и потом усреднить их предсказания. Это может дать дать лучий результат, чем если обучить одну модель сразу на всех данных, без контроля переобучения.
Для примера возьмем библиотеку catboost и будем валидироваться оставшемся фолде
from sklearn.model_selection import KFold from sklearn.datasets import load_iris from catboost import CatBoostClassifier iris = load_iris() # инициализация KFold с 5тью фолдами cv = KFold(n_splits=5, random_state=42, shuffle=True) classifiers = [] # метод split возвращает индексы для объектов train и test for train_index, test_index in cv.split(iris[‘target’]): clf = CatBoostClassifier(random_state=42, iterations=200, verbose=50, learning_rate=0.1) X_train, X_test = iris[‘data’][train_index], iris[‘data’][test_index] y_train, y_test = iris[‘target’][train_index], iris[‘target’][test_index] clf.fit(X_train, y_train, eval_set=(X_test, y_test), use_best_model=True) # получим 5 оптимальных классификаторов classifiers.append(clf)
Источник: zabaykin.ru
8.3 Кросс-валидация — главные песни о качестве
Отбор признаков в задачах машинного обучения. Статистические методы
Часто наборы данных, с которыми приходится работать, содержат большое количество признаков, число которых может достигать нескольких сотен и даже тысяч. При построении модели машинного обучения не всегда понятно, какие из признаков действительно для неё важны (т.е. имеют связь с целевой переменной), а какие являются избыточными (или шумовыми).
Удаление избыточных признаков позволяет лучше понять данные, а также сократить время настройки и обучения модели, улучшить её точность и облегчить интерпретируемость. Иногда эта задача и вовсе может быть самой значимой, например, нахождение оптимального набора признаков может помочь расшифровать механизмы, лежащие в основе проблемы, представляющей интерес для исследования. Это может быть полезным для разработки различных методик, например, банковского скоринга, поиска фрода или медицинских диагностических тестов. Обычно методы отбора признаков делят на 3 категории: статистические методы или фильтры (filters), встроенные алгоритмы (embedded algorithms) и методы обёртки (wrappers). В настоящем цикле статей приведён обзор некоторых из этих методов с обсуждением их достоинств, недостатков и особенностей реализации.
Статистические методы (фильтры)
Статистические методы применяются до обучения модели и как правило имеют низкую стоимость вычислений. Они основаны на визуальном анализе (например, удаление признака, у которого только одно значение, или большинство значений пропущено), оценке признаков с помощью какого-нибудь статистического критерия (дисперсии, корреляции, и др.) и экспертной оценке (удаление признаков, которые не подходят по смыслу – например, «цвет галстука заёмщика» в задаче кредитного скоринга ).
Простейшим способом оценки пригодности признаков является разведочный анализ данных (например, с библиотекой pandas-profiling). Однако при больших размерах датасета сложность этой процедуры значительно возрастает, поэтому её можно автоматизировать с помощью библиотеки feature-selector, которая отбирает признаки по следующим параметрам:
- Количество пропущенных значений (удаляются признаки, у которых процент пропущенных значений больше порогового значения)
- Коэффициент корреляции (удаляются признаки, у которых коэффициент корреляции больше порогового значения)
- Вариативность (удаляются признаки, состоящие из одного значения)
- Оценка важности признаков с помощью lightgbm (удаляются признаки, имеющие низкую важность в модели lightgbm. Следует применять только если модель lightgbm имеет хорошую точность)
Хороший туториал по этой библиотеке находится здесь.
Более сложные методы автоматического отбора признаков реализованы в sklearn. VarianceThreshold отбирает признаки, у которых дисперсия меньше заданного значения. SelectKBest и SelectPercentile оценивают взаимосвязь предикторов с целевой переменной используя статистические методы, позволяя отобрать соответственно заданное количество и долю наилучших признаков.
Методы отбора основаны на F-тестах (обозначаются f_regression и f_classif соответственно для регрессии и классификации), оценке функции взаимной информации (mutual_info_regression и mutual_info_classif) и (chi2 для классификации). F-тесты хорошо работают только с линейными зависимостями, поэтому лучше всего они подойдут для линейной регрессии, а — тесты требуют неотрицательных и правильно отмасштабированных признаков. Поэтому удобнее всего использовать методы, основанные на вычислении взаимной информации – они почти не требуют настройки и позволяют находить нелинейные связи.
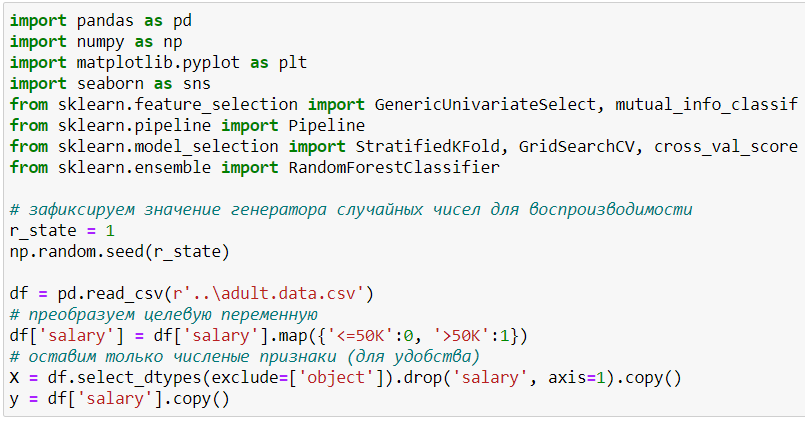
Рассмотрим применение статистических методов в реальной задаче – предсказать, зарабатывает ли человек больше $50 тыс. Загрузим библиотеки и данные, для удобства оставив только численные признаки:
- age – возраст,
- fnlwgt (final weight) – примерная оценка количества людей, которое представляет каждая строка данных,
- educational-num – длительность обучения,
- capital-gain – прирост капитала,
- capital-loss – потеря капитала,
- hours-per-week – количество рабочих часов в неделю.
Посмотрим на данные:
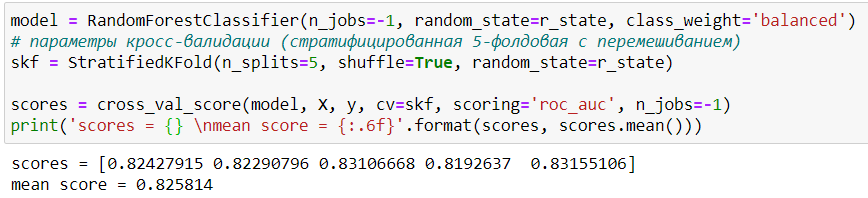
В качестве модели будем использовать случайный лес. Посмотрим точность на кросс-валидации:
И на важность признаков в модели:
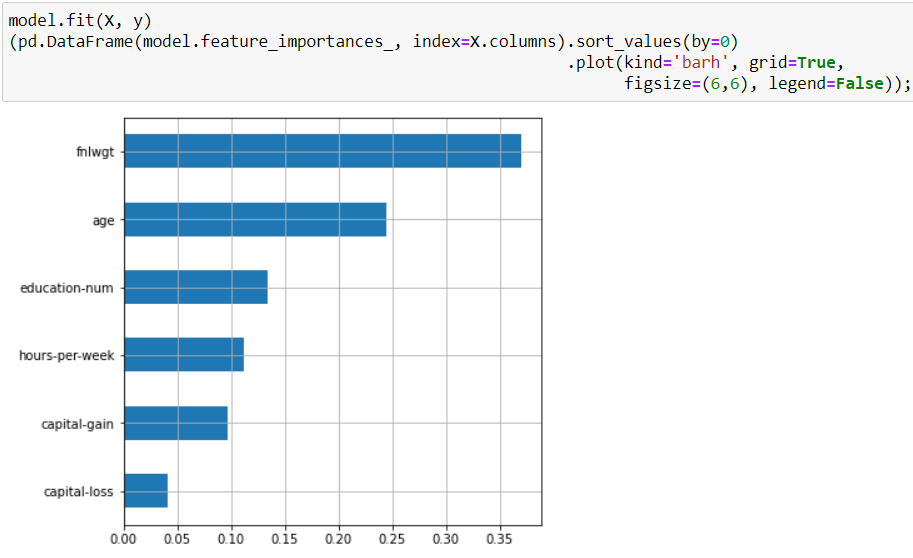
Самым важным признаком в нашей модели является fnlwgt. Это можно интерпретировать как то, что главным фактором того, что человек зарабатывает больше $50 тыс. является количество людей с такими же характеристиками. Такая интерпретация выглядит нелогичной, а происходит это потому, что деревянные модели (случайный лес и бустинг) могут выдавать сильно смещённую оценку признаков (подробнее здесь). При этом, чем хуже настроена модель, тем сильнее может быть смещение. Поэтому доверять оценке признаков таких моделей надо с осторожностью.
Создадим 12 «шумовых» признаков, элементами которых будут не коррелируемые случайные числа из выборок с нормальным и равномерным распределениями. Параметры каждого распределения подбираются случайным образом независимо друг от друга.
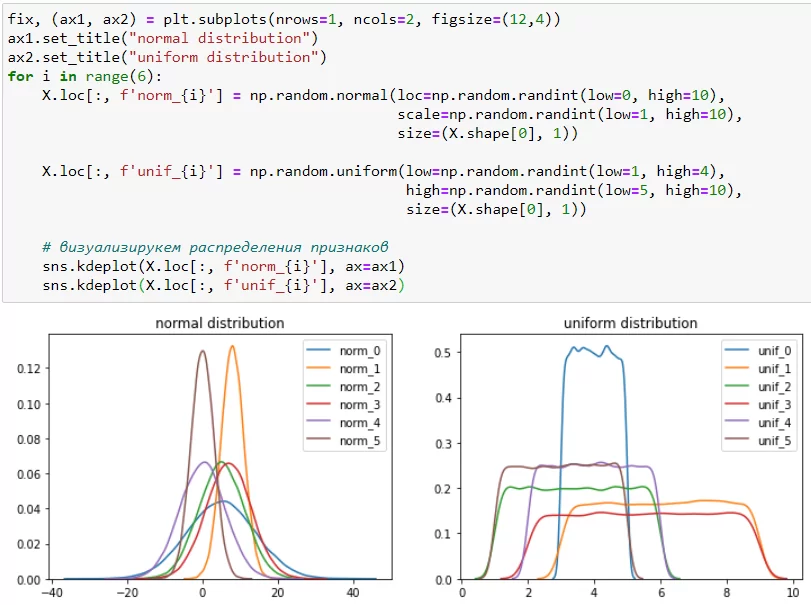
Проведём кросс-валидацию на наших зашумлённых данных и посмотрим на важность признаков:
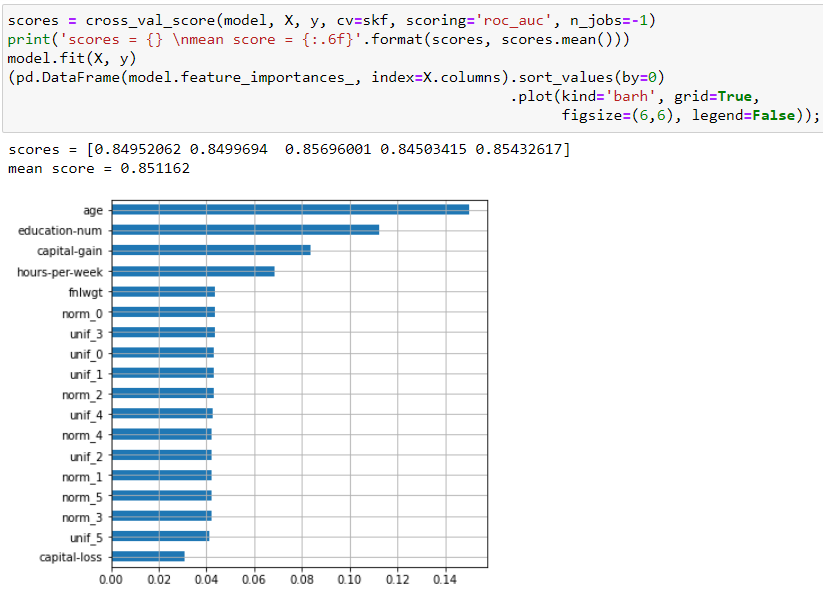
Несмотря на большое количество добавленных шумовых признаков, точность модели на кросс-валидации значительно возросла как на каждом фолде, так и в среднем! Кроме этого, шумовые признаки имеют высокую важность, сравнимую с двумя оригинальными признаками. Очевидно, что наша модель переобучена, однако в реальных задачах такие ситуации бывает очень сложно распознать, особенно когда при удалении некоторых признаков (про которые неизвестно – шумовые они, или нет) падает валидационная точность.
Проведём отбор признаков статистическими методами, для чего будем использовать обобщённый вариант SelectKBest и SelectPercentile, который называется GenericUnivariateSelect. Он принимает на вход 3 параметра – функцию оценки, режим отбора и его параметры. В качестве функции оценки будем использовать метод, основанный на вычислении взаимной информации.
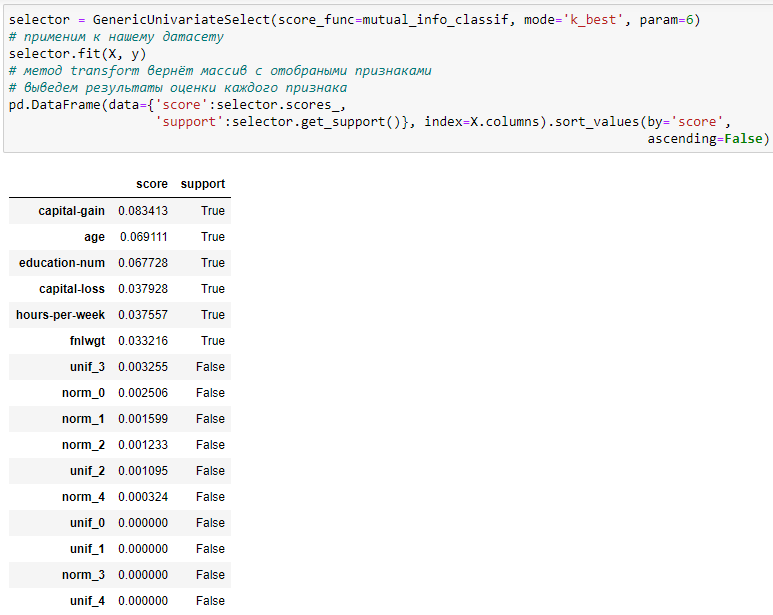
Сгенерированные нами признаки имеют низкое значение оценочной функции (scores_), поэтому в дальнейшем селектор не будет их использовать (get_support()=False).
В реальной задаче (когда количество шумовых признаков неизвестно) параметры GenericUnivariateSelect можно находить на кросс-валидации вместе с другими гиперпараметрами модели. Посмотрим, как изменится точность нашей модели после подбора параметров регуляризации случайного леса и количества признаков селектора:
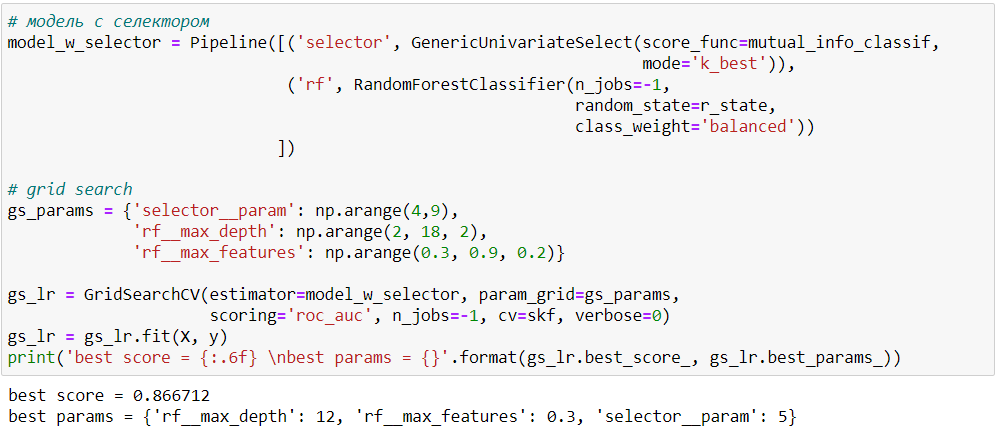
Средняя точность на кросс-валидации значительно выросла, а лучший результат получился всего для 5 признаков. Посмотрим на них:
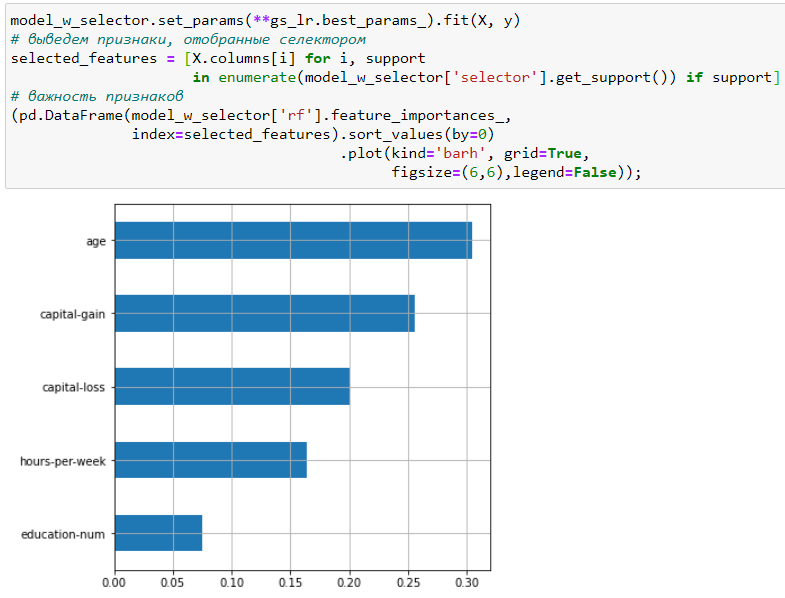
Таким образом лучший результат был получен после удаления шумовых признаков и признака fnlwgt, который при первоначальной оценке был самым значимым для модели. Однако из всех оригинальных признаков он имел наименьшее значение оценочной функции в GenericUnivariateSelect. Результаты оценки важности признаков после отбора имеют более логичную интерпретацию – на заработок человека влияют именно характеристики человека, а не параметры самой выборки. Таким образом статистический отбор признаков бывает полезен для увеличения точности модели и получения менее смещённой оценки для интерпретации её результатов.
Заключение
В статье были рассмотрены некоторые статистические методы отбора признаков. К их достоинствам можно отнести низкую стоимость вычислений (линейно зависит от количества признаков) и хорошую интерпретируемость.
К недостаткам – то, что они рассматривают каждый признак изолировано, поэтому не могут выявить более сложные зависимости в данных, например, зависимость целевой переменой от нескольких предикторов. Кроме того, в некоторых случаях даже небольшое изменение признака (или наличие непустых значений) может быть само по себе очень важным, поэтому к результатам отбора следует относиться критически и по возможности проводить экспертный анализ. Ноутбук, приведённый в статье, доступен в моём репозитории. Более сложные методы отбора признаков будут рассмотрены в следующих статьях цикла.
Источник: newtechaudit.ru
5. Кривые валидации и обучения — 4. Линейные модели классификации.
Это окончание невероятной информации про линейные модели классификации. . пространстве признаков и . В проекции на исходное пространство признаков граница получилась нелинейной. На практике полиномиальные признаки действительно помогают, но строить их явно – вычислительно неэффективно. Гораздо быстрее работает SVM с ядровым трюком. При таком подходе в пространстве высокой размерности считается только расстояние между объектами (задаваемое функцией-ядром), а явно плодить комбинаторно большое число признаков не приходится. Про это подробно можно почитать в курсе Евгения Соколова (математика уже серьезная).
5. Кривые валидации и обучения
- Сделать модель сложнее или упростить?
- Добавить больше признаков?
- Или нам просто нужно больше данных для обучения?
Ответы на данные вопросы не всегда лежат на поверхности. В частности, иногда использование более сложной модели приведет к ухудшению показателей. Либо добавление наблюдений не приведет к ощутимым изменениям. Способность принять правильное решение и выбрать правильный способ улучшения модели, собственно говоря, и отличает хорошего специалиста от плохого.
Будем работать со знакомыми данными по оттоку клиентов телеком-оператора.
Импорт библиотек и чтение данных
from __future__ import division, print_function # отключим всякие предупреждения Anaconda import warnings warnings.filterwarnings(‘ignore’) %matplotlib inline from matplotlib import pyplot as plt import seaborn as sns import numpy as np import pandas as pd from sklearn.preprocessing import PolynomialFeatures from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import LogisticRegression, LogisticRegressionCV, SGDClassifier from sklearn.model_selection import validation_curve data = pd.read_csv(‘../../data/telecom_churn.csv’).drop(‘State’, axis=1) data[‘International plan’] = data[‘International plan’].map() data[‘Voice mail plan’] = data[‘Voice mail plan’].map() y = data[‘Churn’].astype(‘int’).values X = data.drop(‘Churn’, axis=1).values
Логистическую регрессию будем обучать стохастическим градиентным спуском. Пока объясним это тем, что так быстрее, но далее в программе у нас отдельная статья про это дело. Построим валидационные кривые, показывающие, как качество (ROC AUC) на обучающей и проверочной выборке меняется с изменением параметра регуляризации.
alphas = np.logspace(-2, 0, 20) sgd_logit = SGDClassifier(loss=’log’, n_jobs=-1, random_state=17) logit_pipe = Pipeline([(‘scaler’, StandardScaler()), (‘poly’, PolynomialFeatures(degree=2)), (‘sgd_logit’, sgd_logit)]) val_train, val_test = validation_curve(logit_pipe, X, y, ‘sgd_logit__alpha’, alphas, cv=5, scoring=’roc_auc’) def plot_with_err(x, data, **kwargs): mu, std = data.mean(1), data.std(1) lines = plt.plot(x, mu, ‘-‘, **kwargs) plt.fill_between(x, mu — std, mu + std, edgecolor=’none’, facecolor=lines .get_color(), alpha=0.2) plot_with_err(alphas, val_train, label=’training scores’) plot_with_err(alphas, val_test, label=’validation scores’) plt.xlabel(r’$alpha$’); plt.ylabel(‘ROC AUC’) plt.legend();

Тенденция видна сразу, и она очень часто встречается.
- Для простых моделей тренировочная и валидационная ошибка находятся где-то рядом, и они велики. Это говорит о том, что модель недообучилась: то есть она не имеет достаточное кол-во параметров.
- Для сильно усложненных моделей тренировочная и валидационная ошибки значительно отличаются. Это можно объяснить переобучением: когда параметров слишком много либо не хватает регуляризации, алгоритм может «отвлекаться» на шум в данных и упускать основной тренд.
Сколько нужно данных?
Известно, что чем больше данных использует модель, тем лучше. Но как нам понять в конкретной ситуации, помогут ли новые данные? Скажем, целесообразно ли нам потратить N$ на труд асессоров, чтобы увеличить выборку вдвое?
Поскольку новых данных пока может и не быть, разумно поварьировать размер имеющейся обучающей выборки и посмотреть, как качество решения задачи зависит от объема данных, на котором мы обучали модель. Так получаются кривые обучения (learning curves).
Идея простая: мы отображаем ошибку как функцию от количества примеров, используемых для обучения. При этом параметры модели фиксируются заранее.
Давайте посмотрим, что мы получим для линейной модели. Коэффициент регуляризации выставим большим.
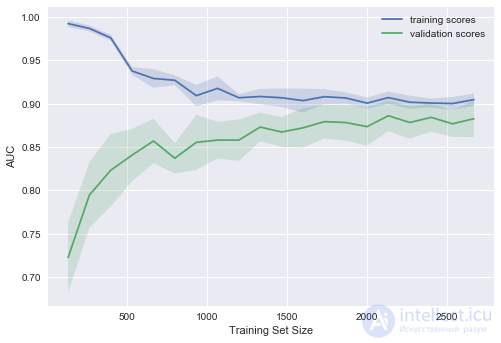
from sklearn.model_selection import learning_curve def plot_learning_curve(degree=2, alpha=0.01): train_sizes = np.linspace(0.05, 1, 20) logit_pipe = Pipeline([(‘scaler’, StandardScaler()), (‘poly’, PolynomialFeatures(degree=degree)), (‘sgd_logit’, SGDClassifier(n_jobs=-1, random_state=17, alpha=alpha))]) N_train, val_train, val_test = learning_curve(logit_pipe, X, y, train_sizes=train_sizes, cv=5, scoring=’roc_auc’) plot_with_err(N_train, val_train, label=’training scores’) plot_with_err(N_train, val_test, label=’validation scores’) plt.xlabel(‘Training Set Size’); plt.ylabel(‘AUC’) plt.legend() plot_learning_curve(degree=2, alpha=10)

Типичная ситуация: для небольшого объема данных ошибки на обучающей выборке и в процессе кросс-валидации довольно сильно отличаются, что указывает на переобучение. Для той же модели, но с большим объемом данных ошибки «сходятся», что указывается на недообучение.
Если добавить еще данные, ошибка на обучающей выборке не будет расти, но с другой стороны, ошибка на тестовых данных не будет уменьшаться.
Получается, ошибки «сошлись», и добавление новых данных не поможет. Собственно, это случай – самый интересный для бизнеса. Возможна ситуация, когда мы увеличиваем выборку в 10 раз. Но если не менять сложность модели, это может и не помочь. То есть стратегия «настроил один раз – дальше использую 10 раз» может и не работать.
Что будет, если изменить коэффициент регуляризации (уменьшить до 0.05)?
Видим хорошую тенденцию – кривые постепенно сходятся, и если дальше двигаться направо (добавлять в модель данные), можно еще повысить качество на валидации.
А если усложнить модель еще больше ()?
Проявляется переобучение – AUC падает как на обучении, так и на валидации.

Строя подобные кривые, можно понять, в какую сторону двигаться, и как правильно настроить сложность модели на новых данных.
Выводы по кривым валидации и обучения
- Ошибка на обучающей выборке сама по себе ничего не говорит о качестве модели
- Кросс-валидационная ошибка показывает, насколько хорошо модель подстраивается под данные (имеющийся тренд в данных), сохраняя при этом способность обобщения на новые данные
- Валидационная кривая представляет собой график, показывающий результат на тренировочной и валидационной выборке в зависимости от сложности модели:
- если две кривые распологаются близко, и обе ошибки велики, — это признак недообучения
- если две кривые далеко друг от друга, — это показатель переобучения
- Кривая обучения — это график, показывающий результаты на валидации и тренировочной подвыборке в зависимости от количества наблюдений:
- если кривые сошлись друг к другу, добавление новых данных не поможет – надо менять сложность модели
- если кривые еще не сошлись, добавление новых данных может улучшить результат.
6. Достоинства и недостатки линейных моделей в задачах машинного обучения
- Хорошо изучены
- Очень быстрые, могут работать на очень больших выборках
- Практически вне конкуренции, когда признаков очень много (от сотен тысяч и более), и они разреженные (хотя есть еще факторизационные машины)
- Коэффициенты перед признаками могут интерпретироваться (при условии что признаки масштабированы) – в линейной регрессии как частные производные зависимой переменной от признаков, в логистической – как изменение шансов на отнесение к одному из классов в раз при изменении признака на 1 ед., подробнее тут
- Логистическая регрессия выдает вероятности отнесения к разным классам (это очень ценится, например, в кредитном скоринге)
- Модель может строить и нелинейную границу, если на вход подать полиномиальные признаки
- Плохо работают в задачах, в которых зависимость ответов от признаков сложная, нелинейная
- На практике предположения теоремы Маркова-Гаусса почти никогда не выполняются, поэтому чаще линейные методы работают хуже, чем, например, SVM и ансамбли (по качеству решения задачи классификации/регрессии)
7. Самостоятельная работа
Актуальные домашние задания объявляются во время очередной сессии курса, следить можно в группе ВК и в репозитории курса.
В качестве закрепления изученного материала предлагаем следующее задание: разобраться с тем, как работает TfidfVectorizer и DictVectorizer, обучить и настроить модель линейной регрессии Ridge на данных о публикациях на Хабрахабре и воспроизвести бенчмарк в соревновании. Проверить себя можно отправив ответы в веб-форме (там же найдете и решение).
Вау!! Ты еще не читал? Это зря!
- Регрессия
- Принцип Харди – Вайнберга
- Внутренняя валидность
- Закон больших чисел
- Мартингейл
- Разбавление регрессии
- Критерий отбора
- Метод наименьших квадратов
Надеюсь, эта статья об линейные модели классификации, была вам интересна и не так слона для восприятия как могло показаться, удачи в ваших начинаниях! Надеюсь, что теперь ты понял что такое линейные модели классификации, линейная регрессия, логическая регрессия, регуляризация логистической регрессии и для чего все это нужно, а если не понял, или есть замечания, то нестесняся пиши или спрашивай в комментариях, с удовольствием отвечу. Для того чтобы глубже понять настоятельно рекомендую изучить всю информацию из категории Машинное обучение
Продолжение:
Ответы на вопросы для самопроверки пишите в комментариях, мы проверим, или же задавайте свой вопрос по данной теме.
Источник: intellect.icu