
Взгляд StatSoft: Итак, реальная значимость Big Data в распределенных файловых системах состоит не в том, чтобы построить прогностические модели на основе всех данных; точность моделей не будет выше.
Более значимым является использование всего объема данных для сегментации и кластеризации, что позволит эффективно строить большое количество моделей для небольших кластеров.
Предисловие
“Big data” – модный нынче термин, фигурирующий почти на всех профессиональных конференциях, посвященных анализу данных, прогностической аналитике, интеллектуальному анализу данных (data mining), CRM. Термин используется в сферах, где актуальна работа с качественно большими объемами данных, где постоянно происходит увеличение скорости потока данных в организационный процесс: экономике, банковской деятельности, производстве, маркетинге, телекоммуникациях, веб-аналитике, медицине и др.
Вместе со стремительным накоплением информации быстрыми темпами развиваются и технологии анализа данных. Если еще несколько лет назад было возможно, скажем, лишь сегментировать клиентов на группы со схожими предпочтениями, то теперь возможно строить модели для каждого клиента в режиме реального времени, анализируя, например, его перемещение по сети Интернет для поиска конкретного товара. Интересы потребителя могут быть проанализированы, и в соответствии с построенной моделью выведена подходящая реклама или конкретные предложения. Модель также может настраиваться и перестраиваться в режиме реального времени, что было немыслимо еще несколько лет назад.
Что такое Big Data за 6 минут
В области телекоммуникации, например, развиты технологии для определения физического расположения сотовых телефонов и их владельцев, и, кажется, в скором времени станет реальностью идея, описанная в научно-фантастическом фильме «Особое мнение», 2002 года, где отображение рекламной информации в торговых центрах учитывала интересы конкретных лиц, проходящих мимо.
В то же время, существуют ситуации, когда увлечение новыми технологиями может привести и к разочарованию. Например, иногда разреженные данные (Sparse data), дающие важное понимание действительности, являются гораздо более ценными, чем Большие данные (Big Data), описывающие горы, зачастую, не существенной информации.
Цель данной статьи – прояснить и обдумать новые возможности Big Data и проиллюстрировать, как аналитическая платформа STATISTICA компании StatSoft может помочь в эффективном использовании Big Data для оптимизации процессов и решения задач.
Насколько большие Big Data?
Конечно, правильный ответ на данный вопрос должен звучать — «это зависит…»
В современных обсуждениях понятие Big Data описывают как данные объема в порядках терабайт.
На практике (если речь идет о гигабайтах или терабайтах), такие данные легко хранить и управлять ими с помощью «традиционных» баз данных и стандартного оборудования (сервера баз данных).
Программное обеспечение STATISTICA использует многопоточную технологию для алгоритмов доступа к данным (чтения), преобразования и построения прогностических (и скоринговых) моделей, поэтому такие выборки данных могут быть легко проанализированы, и не требуют специализированных инструментов.
В некоторых текущих проектах StatSoft обрабатываются выборки порядка 9-12 миллионов строк. Умножим их на 1000 параметров (переменных), собранных и организованных в хранилище данных для построения рисковых или прогностических моделей. Такого рода файл будет иметь объем “только” около 100 гигабайт. Это, конечно, не маленькое хранилище данных, но его размеры не превышают возможностей технологии стандартных баз данных.
Линейка продуктов STATISTICA для пакетного анализа и построения скоринговых моделей (STATISTICA Enterprise), решения, работающие в режиме реального времени (STATISTICA Live Score), и аналитические инструменты для создания и управления моделями (STATISTICA Data Miner, Decisioning) легко масштабируются на несколько серверов с многоядерными процессорами.
На практике это означает, что достаточная скорость работы аналитических моделей (например, прогнозы в отношении кредитного риска, вероятности мошенничества, надежности узлов оборудования, и т.д.) позволяющая принимать оперативные решения, почти всегда может быть достигнута с помощью стандартных инструментов STATISTICA.
От больших объемов данных к Big Data
Как правило, обсуждение Big Data сосредоточено вокруг хранилищ данных (и проведении анализа, основанных на таких хранилищах), объемом намного больше, чем просто несколько терабайт.
В частности, некоторые хранилища данных могут вырасти до тысячи терабайт, т.е., до петабайт (1000 терабайт = 1 петабайт).
За пределами петабайт, накопление данных может быть измерено в эксабайтах, например, в производственном секторе по всему миру в 2010 году, по оценкам, накоплено в общей сложности 2 эксабайта новой информации (Manyika et al., 2011 г.).
Существуют отрасли, где данные собираются и накапливаются очень интенсивно.
Например, в производственной сфере, такой как электростанции, непрерывный поток данных генерируется иногда для десятков тысяч параметров каждую минуту или даже каждую секунду.
Кроме того, за последние несколько лет, внедряются так называемые “smart grid” технологии, позволяющие коммунальным службам измерять потребление электроэнергии отдельными семьями каждую минуту или каждую секунду.
Для такого рода приложений, в которых данные должны храниться годами, накопленные данные классифицируются как Extremely Big Data.
Растет и число приложений Big Data среди коммерческих и государственных секторов, где объем данных в хранилищах, может составлять сотни терабайт или петабайт.
Современные технологии позволяют «отслеживать» людей и их поведение различными способами. Например, когда мы пользуемся интернетом, делаем покупки в Интернет-магазинах или крупных сетях магазинов, таких как Walmart (согласно Википедии, хранилище данных Walmart оценивается более чем в 2 петабайт), или перемещаемся с включенными мобильными телефонами – мы оставляем след наших действий, что приводит к накоплению новой информации.
Различные способы связи, от простых телефонных звонков до загрузки информации через сайты социальных сетей, таких как Facebook (согласно данным Википедии, обмен информацией каждый месяц составляет 30 млрд. единиц), или обмен видео на таких сайтах, как YouTube (Youtube утверждает, что он загружает 24 часа видео каждую минуту; см. Wikipedia), ежедневно генерируют огромное количество новых данных.
Аналогичным образом, современные медицинские технологии генерируют большие объемы данных, относящиеся к оказанию медицинской помощи (изображения, видео, мониторинг в реальном времени).
Итак, классификацию объемов данных можно представить так:
Большие наборы данных: от 1000 мегабайт (1 гигабайт) до сотен гигабайт
Огромные наборы данных: от 1000 гигабайт (1терабайт) до нескольких терабайт
Big Data: от нескольких терабайт до сотен терабайт
Extremely Big Data: от 1000 до 10000 терабайт = от 1 до 10 петабайт
Задачи, связанные с Big Data
Существуют три типа задач связанных с Big Data:
1. Хранение и управление
Объем данных в сотни терабайт или петабайт не позволяет легко хранить и управлять ими с помощью традиционных реляционных баз данных.
2. Неструктурированная информация
Большинство всех данных Big Data являются неструктурированными. Т.е. как можно организовать текст, видео, изображения, и т.д.?
3. Анализ Big Data
Как анализировать неструктурированную информацию? Как на основе Big Data составлять простые отчеты, строить и внедрять углубленные прогностические модели?
Хранение и управление Big Data
Big Data обычно хранятся и организуются в распределенных файловых системах.
В общих чертах, информация хранится на нескольких (иногда тысячах) жестких дисках, на стандартных компьютерах.
Так называемая «карта» (map) отслеживает, где (на каком компьютере и/или диске) хранится конкретная часть информации.
Для обеспечения отказоустойчивости и надежности, каждую часть информации обычно сохраняют несколько раз, например – трижды.
Так, например, предположим, что вы собрали индивидуальные транзакции в большой розничной сети магазинов. Подробная информация о каждой транзакции будет храниться на разных серверах и жестких дисках, а «карта» (map) индексирует, где именно хранятся сведения о соответствующей сделке.
С помощью стандартного оборудования и открытых программных средств для управления этой распределенной файловой системой (например, Hadoop), сравнительно легко можно реализовать надежные хранилища данных в масштабе петабайт.
Неструктурированная информация
Большая часть собранной информации в распределенной файловой системе состоит из неструктурированных данных, таких как текст, изображения, фотографии или видео.
Это имеет свои преимущества и недостатки.
Преимущество состоит в том, что возможность хранения больших данных позволяет сохранять “все данные”, не беспокоясь о том, какая часть данных актуальна для последующего анализа и принятия решения.
Недостатком является то, что в таких случаях для извлечения полезной информации требуется последующая обработка этих огромных массивов данных.
Хотя некоторые из этих операций могут быть простыми (например, простые подсчеты, и т.д.), другие требуют более сложных алгоритмов, которые должны быть специально разработаны для эффективной работы на распределенной файловой системе.
Один топ-менеджер однажды рассказал StatSoft что он «потратил целое состояние на IT и хранение данных, но до сих пор не начал получать денег», потому что не думал о том, как лучше использовать эти данные для улучшения основной деятельности.
Итак, в то время как объем данных может расти в геометрической прогрессии, возможности извлекать информацию и действовать на основе этой информации, ограничены и будут асимптотически достигать предела.
Важно, чтобы методы и процедуры для построения, обновления моделей, а также для автоматизации процесса принятия решений были разработаны наряду с системами хранения данных, чтобы гарантировать, что такие системы являются полезными и выгодными для предприятия.
Анализ Big Data
Это действительно большая проблема, связанная с анализом неструктурированных данных Big Data: как анализировать их с пользой. О данном вопросе написано гораздо меньше, чем о хранении данных и технологиях управления Big Data.
Есть ряд вопросов, которые следует рассмотреть.
Map-Reduce
При анализе сотни терабайт или петабайт данных, не представляется возможным извлечь данные в какое-либо другое место для анализа (например, в STATISTICA Enterprise Analysis Server).
Процесс переноса данных по каналам на отдельный сервер или сервера (для параллельной обработки) займет слишком много времени и требует слишком большого трафика.
Вместо этого, аналитические вычисления должны быть выполнены физически близко к месту, где хранятся данные.
Алгоритм Map-Reduce представляет собой модель для распределенных вычислений. Принцип его работы заключается в следующем: происходит распределение входных данных на рабочие узлы (individual nodes) распределенной файловой системы для предварительной обработки (map-шаг) и, затем, свертка (объединение) уже предварительно обработанных данных (reduce-шаг).
Таким образом, скажем, для вычисления итоговой суммы, алгоритм будет параллельно вычислять промежуточные суммы в каждом из узлов распределенной файловой системы, и затем суммировать эти промежуточные значения.
В Интернете доступно огромное количество информации о том, каким образом можно выполнять различные вычисления с помощью модели map-reduce, в том числе и для прогностической аналитики.
Простые статистики, Business Intelligence (BI)
Для составления простых отчетов BI, существует множество продуктов с открытым кодом, позволяющих вычислять суммы, средние, пропорции и т.п. с помощью map-reduce.
Таким образом, получить точные подсчеты и другие простые статистики для составления отчетов очень легко.
Прогнозное моделирование, углубленные статистики
На первый взгляд может показаться, что построение прогностических моделей в распределенной файловой системой сложнее, однако это совсем не так. Рассмотрим предварительные этапы анализа данных.
Подготовка данных. Некоторое время назад StatSoft провел серию крупных и успешных проектов с участием очень больших наборов данных, описывающих поминутные показатели процесса работы электростанции. Цель проводимого анализа заключалась в повышении эффективности деятельности электростанции и понижении количества выбросов (Electric Power Research Institute, 2009).
Важно, что, несмотря на то, что наборы данных могут быть очень большими, информация, содержащаяся в них, имеет значительно меньшую размерность.
Например, в то время как данные накапливаются ежесекундно или ежеминутно, многие параметры (температура газов и печей, потоки, положение заслонок и т.д.) остаются стабильными на больших интервалах времени. Иначе говоря, данные, записывающиеся каждую секунду, являются в основном повторениями одной и той же информации.
Таким образом, необходимо проводить “умное” агрегирование данных, получая для моделирования и оптимизации данные, которые содержат только необходимую информацию о динамических изменениях, влияющих на эффективность работы электростанции и количество выбросов.
Классификация текстов и предварительная обработка данных. Проиллюстрируем ещё раз, как большие наборы данных могут содержать гораздо меньше полезной информации.
Например, StatSoft участвовал в проектах, связанных с анализом текстов (text mining) из твитов, отражающих, насколько пассажиры удовлетворены авиакомпаниями и их услугами.
Несмотря на то, что ежечасно и ежедневно было извлечено большое количество соответствующих твитов, настроения, выраженные в них, были довольно простыми и однообразными. Большинство сообщений – жалобы и краткие сообщения из одного предложения о “плохом опыте”. Кроме того, число и “сила” этих настроений относительно стабильны во времени и в конкретных вопросах (например, потерянный багаж, плохое питание, отмена рейсов).
Таким образом, сокращение фактических твитов до скора (оценки) настроения, используя методы text mining (например, реализованные в STATISTICA Text Miner), приводит к гораздо меньшему объему данных, которые затем могут быть легко сопоставлены с существующими структурированными данными (фактические продажи билетов, или информация о часто летающих пассажирах). Анализ позволяет разбить клиентов на группы и изучить их характерные жалобы.
Существует множество инструментов для проведения такого агрегирования данных (например, скор настроений) в распределенной файловой системе, что позволяет легко осуществлять данный аналитический процесс.
Построение моделей
Часто задача состоит в том, чтобы быстро построить точные модели для данных, хранящихся в распределенной файловой системе.
Существуют реализации map-reduce для различных алгоритмов data mining/прогностической аналитики, подходящих для масштабной параллельной обработки данных в распределенной файловой системе (что может быть поддержано с помощью платформы STATISTICА StatSoft).
Однако, именно из-за того, что вы обработали очень большое количество данных, уверенны ли вы, что итоговая модель является действительно более точной?
На самом деле, скорее всего, удобнее строить модели для небольших сегментов данных в распределенной файловой системе.
Как говорится в недавнем отчете Forrester: «Два плюс два равняется 3,9 – это обычно достаточно хорошо» (Hopkins точность моделей не будет выше.
Более значимым является использование всего объема данных для сегментации и кластеризации, что позволит эффективно строить большое количество моделей для небольших кластеров.
Например, можно ожидать, что модели, основанные на широкой сегментации (20-30 лет), будут менее точными, чем большое число моделей, построенных на более детальной сегментации (например, 20-21-летние студенты, проживающие в общежитии, и учащиеся на факультете бизнеса).
Таким образом, один из способов получения преимуществ Big Data заключается в том, чтобы использовать доступную информацию для построения большого количества моделей для большого числа сегментов и, затем, по соответствующей модели строить прогнозы.
В предельном случае, каждый отдельный «человек» в большом хранилище данных клиентов может иметь свою собственную модель для прогнозирования будущих покупок.
Это означает, что аналитическая платформа (например, STATISTICA Enterprise), поддерживающая хранилища данных, должна быть в состоянии управлять сотнями или даже тысячами моделей, и иметь возможность перенастраивать их, когда это необходимо.
Интеграция со STATISTICA
Выборка, сокращение данных, отбор данных с помощью map-reduce. Что это означает для анализа Big Data?
Существуют эффективные (map-reduce) алгоритмы получения выборки, доступные для распределенных файловых систем, с помощью которых Big Data становятся пригодными для построения прогностических моделей.
Для решения многих задач это очень удобный способ, например, развертывание STATISTICA Enterprise и Data Mining платформы над интерфейсом данных в распределенной файловой системе для выполнения операций подготовки данных/агрегирования и/или вероятностной выборки, использующих алгоритмы map-reduce (и управлемых платформой Enterprise).
В дополнение, можно также строить детальные выборки (например, на основе микросегментации специфичных групп клиентов) и предоставлять данные STATISTICA для построения моделей для специфичных сегментов.
Интеграция STATISTICA с open-source инструментами. Уникальное достоинство STATISTICA Enterprise и Data Mining платформы в том, что она специально разработана как корпоративная платформа с использованием стандартных интерфейсов для сценариев и данных.
Это значит, что не только инструменты StatSoft, но и open-source инструменты, а также специализированная аналитика с использованием алгоритмов map-reduce, могут быть легко интегрированы в платформу STATISTICA, управляться через неё как отдельный узел в рабочей среде.
Например, платформа R, часто используемая аналитиками для проведения специализированных вычислений, легко взаимодействует со STATISTICA. Скрипты R уже много лет, как могут быть выполнены из среды STATISTICA.
Методы анализа Big Data появляются и развиваются очень быстро. Важно, чтобы аналитическая платформа для распределенной файловой системы могла легко использовать новые методы подготовки и агрегирования данных, выборки и стратификации.
Реализации специализированных процедур map-reduce. В дополнение к легкой интеграции с open-source и другими инструментами и платформами, не менее важно, что аналитическая платформа STATISTICA обеспечивает возможность гибкой настройки рабочей среды аналитика для решения конкретных задач на основе распределенной файловой системы и Big Data.
Появляются и развиваются различные методы анализа и использования Big Data, и на данный момент нет «традиционных» прогностических методов, стандартных подходов, которые были бы хорошо задокументированы.
Однако данная ситуация может измениться довольно быстро, так как все крупнейшие поставщики баз данных и BI инструментов (Microsoft, Oracle, Teradata, и другие) оперативно предоставляют интерфейсы и инструменты для доступа и обработки данных.
Так или иначе, платформа STATISTICA Enterprise предоставляет вам возможность пользовательской настройки конкретных аналитических подходов, основанных на данных в распределенных файловых системах, а также поддерживает нестандартные интерфейсы и инструменты.
Критика Big Data
Хранение Big Data не всегда приводит к получению выгоды
Хранение огромного количества данных, описывающих некоторые легко наблюдаемые события, не всегда приводит к выгодному понимаю реальности.
Это в равной мере относится к анализу акций, каналов twitter, медицинских данных, данных CRM, или мониторингу комплекса оборудования для диагностического обслуживания.
Например, достоверный список потенциальных покупателей товаров, наряду с демографической информацией, а также информацией о чистой стоимости товаров, могут быть гораздо более ценными для поставщиков, чем массивное хранилище данных о кликах на различных сайтах онлайн-магазинов.
При мониторинге работы электростанций, мы узнали, [и продемонстрировали, см. Electric Power Research Institute (EPRI), 2009], что обращение внимания именно на определенные фрагменты информации и на изменения, которые происходят в некоторых параметрах (или их комбинациях), более информативны для последующего представления, чем мониторинг тысячи параметров потоков данных за каждую секунду.
Как и в случае любого проекта по оптимизации организационной или коммерческой деятельности, важно начать с вопросов: “Как должны в идеале выглядеть результаты?”, “Как я могу измерить успех?“ и «Какая информация более информативна и полезна для достижения идеального результата?».
Ответы на эти вопросы вполне могут привести к реализации хранилища Big Data, однако во многих случаях – могут и не привести.
Скорость обновления данных и «актуальный» временной интервал
Может случиться, что вы строите модели на производстве, предсказывающие неполадки на одну секунду вперед на основе непрерывного потока данных для тысяч параметров. Однако если это требует, чтобы инженер два часа детализировал результат и «что-то делал», то такая система может быть бессмысленной.
Для поставщиков домашней фурнитуры, было бы важнее получить “сигнал” за месяц или два перед тем, как осуществится покупка жилья, вместо информации в режиме реального времени уже после покупки, когда потенциальный клиент просматривает различные Интернет-сайты в поисках фурнитуры.
Раннее оповещение позволило бы поставщикам завести контакты с потенциальным клиентом, предоставить специальные предложения и, возможно, побудить посетить магазин.
В целом, следует начинать с четкого определения необходимых параметров и стратегии того, как добиться успехов в той или иной области.
После этого уже будет очевиден необходимый временной интервал обновления данных, а, следовательно, и требования к оптимальному плану сбора данных, их хранению и анализу.
Итоги
Цель данной статьи – дать краткий обзор определенных сложностей, связанных с Big Data: хранилищами данных объемом в терабайт, петабайт (и больше), технологиями и подходами для преодоления сложностей получения значимой информации из Big Data.
Итак, создание и поддержка хранилищ объемом в терабайт, петабайт и более стало возможным благодаря технологиям распределенных файловых систем.
В распределенных системах, вместо хранения данных в одной файловой системе, данные сохраняются и индексируются на нескольких (и даже тысячах) жестких дисках и серверах. Создается также «карта» (map), где содержится информация о том, где именно находятся те или иные данные.
Hadoop является одной из самых известных систем, использующих данный подход.
Чтобы обработать данные в распределенной файловой системе, необходимо проводить низкоуровневые вычисления, такие как суммирование, агрегирование и др. в месте их физического размещения в распределенной файловой системе. Создать карту (map) проведенных вычислительных алгоритмов и отслеживать локальные результаты. Затем, аккумулировать результаты (reduced). Данный подход и шаблон проведения вычислительных алгоритмов получил название Map-Reduce.
На практике, анализ Big Data редко заключается в том, чтобы вычислить статистические итоги по всем данным. Вместо этого значимость Big Data заключается в возможности разделения данных на «микро-сегменты» и с помощью методов data mining и прогностического моделирования построить большое число моделей для небольших групп наблюдений.
С точки зрения реализации, аналитическая платформа для работы с Big Data должна уметь использовать новые технологии map-reduce.
Платформа STATISTICA Enterprise и Decisioning предоставляет все возможности для эффективной работы с Big Data, а также позволяет управлять тысячами моделей, применяемых в отношении таких данных.
Словарь
Как правило, обсуждение Big Data в контексте прогнозного моделирования и анализа данных имеет отношение к хранилищам данных (и к анализу, основанного на таких хранилищах), с объемом больше, чем несколько терабайт (1 терабайт = 1,000 гигабайт; 1 гигабайт = 1,000 мегабайт).
Некоторые хранилища данных могут вырастать до тысячи терабайт, т.е., до диапазона петабайт (от 1000 терабайт = 1 петабайт).
Сверх петабайт, накопление данных может быть измерено в эксабайтах, например, в производственном секторе по всему миру в 2010 году, по оценкам, хранится в общей сложности 2 эксабайт новой информации (Manyika et al., 2011 г.).
Distributed File System — Распределенная файловая система
Big Data (несколько терабайт, петабайт) могут быть сохранены и систематизированы в распределенных файловых системах.
В самых общих чертах, информация хранится на одном из нескольких (иногда тысяч) жестких дисков на стандартных компьютерах.
Так называемая «карта» (map) отслеживает, где (на каком компьютере или диске) хранится конкретная информация.
Для надежности, каждую порцию информации обычно сохраняют несколько раз, например, трижды.
Так, например, предположим, что вы накапливаете индивидуальные сделки в большой розничной сети магазинов. Подробная информация о каждой транзакции будет храниться на разных серверах и жестких дисках, а главная карта (map) отслеживает, где точно хранятся сведения о соответствующей сделке.
С помощью стандартного технического обеспечения и открытых программных средств для управления этой распределенной файловой системы (такой, как Hadoop), надежные хранилища данных могут быть реализованы сравнительно легко.
Exabyte — Эксабайт
1 эксабайт это 1000 петабайт, или 1000 * 1000 терабайт.
Распределенная файловая система для хранения и управления хранилищами данных в диапазоне от нескольких терабайт до петабайт.
Принцип работы алгоритма Map-reduce заключается в следующем: происходит распределение входных данных на рабочие узлы (individual nodes) распределенной файловой системы для предварительной обработки (map-шаг) и, затем, свертка (объединение) уже предварительно обработанных данных (reduce-шаг).
Таким образом, скажем, для вычисления итоговой суммы, алгоритм будет параллельно вычислять промежуточные итоги в каждом из узлов распределенной файловой системы, и затем суммировать промежуточные итоги.
Petabyte — Петабайт
1 петабайт = 1000 терабайт.
Terabyte -Терабайт
1 терабайт = 1000 гигабайт.
Современные распределенные файловые системы, такие как Hadoop, делают возможным хранение и управление несколькими терабайт данных в одном хранилище.
Источник: statsoft.ru
Большие данные (Big Data)
Компьютерная обработка информации используется уже несколько десятков лет, но термин «большие данные» – Big Data – широко распространился только к 2011 году. Благодаря большим данным компании научились быстро извлекать коммерческую ценность из самых разных источников, включая соцсети, геолокационные данные, передаваемые телефонами и другими роуминговыми устройствами, общедоступные сведения из сети Интернет, показания датчиков, встроенных в автомобили, здания и другие объекты.
Что такое VVV?
Аналитики используют модель 3V / VVV для определения сути больших данных. Это обозначение – сокращение от названий трех ключевых принципов Big Data: volume, velocity, variety (объем, скорость и разнообразие соответственно).
- Объем означает, что Big Data анализирует большие массивы информации – от 10 ТБ.
- Скорость означает, что информация для Big Data очень быстро генерируется и меняется (достаточно вспомнить, с какой скоростью распространяются новые хэштеги в Twitter).
- Разнообразие означает, что данные в нескольких форматах поступают из многочисленных источников (например, текстовые и видеосообщения из соцсетей, показания геолокационных сервисов).
Где используется Big Data
Big Data – это массивы разноплановой информации, которая часто генерируется, обновляется и предоставляется несколькими источниками. Это используют современные компании, чтобы работать более эффективно, создавать новые продукты и, в конце концов, становиться более конкурентоспособными. Большие данные накапливаются ежесекундно – даже сейчас, когда вы читаете эту статью, кто-то собирает информацию о ваших предпочтениях и действиях в браузере. Большинство компаний используют Big Data для улучшения клиентского сервиса, другие – для улучшения операционных данных и для прогнозирования рисков.
Например, VISA использует Big Data для уменьшения числа мошеннических операций, разработчики игры World of Tanks – для уменьшения оттока геймеров, Министерство труда Германии – для анализа заявок на оформление пособий по безработице, а крупные ритейлеры составляют масштабные маркетинговые кампании, чтобы продать как можно больше товаров.
Как выглядит работа с Big Data?
Ее можно условно разбить на такие этапы:
- Сбор данных. Это могут быть открытые и внутренние источники. К первым относятся: данные государственных сервисов, общедоступная коммерческая информация, социальные сети, интернет-сервисы. Ко вторым – аналитика, данные об онлайн-транзакциях). Для передачи информации используются стандартные интерфейсы приложений и протоколов.
- Интеграция данных. Специальные системы преобразовывают их в формат, подходящий для хранения, или непрерывно отслеживают для важных триггеров.
- Обработка и анализ. Операции выполняются в режиме real time за исключением случаев, когда информация сохраняется в виде функций для последующей обработки. Популярные методики анализа: обучение ассоциативным правилам, классификация, кластерный и регрессионный анализ, смешение и интеграция данных, машинное обучение, распознавание образов и другие.
Важный элемент работы с Big Data – поиск, который позволяет получать необходимую информацию разными путями. В простом случае это работает так же, как Google. Данные доступны для внутренних и внешних сторон платно или бесплатно – все зависит от условий владения ими. Big Data востребованы у разработчиков приложений и сервисов, торговых и телекоммуникационных компаний.
Для бизнес-пользователей информация предлагается в визуализированной форме, простой для восприятия. Если формат текстовый, то это будут лаконичные списки и выдержки, если графический – диаграммы, графики и анимация.
Как выбрать платформу для работы с Big Data?
Работа с Big Data предполагает использование специфической инфраструктуры, ориентированной на параллельную обработку и распределенное хранение больших объемов данных. Но универсального решения для этой цели нет. Хотя на выбор оборудования влияет огромное число факторов, единственно важным является ПО для сбора и анализа Big Data. Соответственно, процесс покупки аппаратного обеспечения для компании будет таким:
- Выбор поставщика ПО для работы с Big Data.
- Изучение требований к инфраструктуре, предъявляемых разработчиками ПО.
- Выбор аппаратных решений на основе этих требований.
- Закупка необходимого оборудования.
Таким образом, каждый проект будет в своем роде уникальным, а оборудование для его развертывания будет зависеть от выбранного ПО. Возьмем для примера два серверных решения, которые адаптированы под работу с Big Data.
FUJITSU Integrated System PRIMEFLEX for Hadoop
Это производительная и гибко масштабируемая платформа, предназначенная для быстрого анализа больших массивов данных разных типов. Она объединяет собой преимущества предварительно сконфигурированной аппаратной платформы, работающей на базе стандартных отраслевых компонентов, и специализированного ПО с открытым исходным кодом. Последнее предоставлено компаниями Cloudera и Datameer. Производитель гарантирует совместимость компонентов системы и ее эффективность для комплексного анализа структурированных и неструктурированных данных. PRIMEFLEX для Hadoop предлагается в готовом к использованию виде в комплекте с услугами по бизнес-консультированию в вопросах Big Data, интеграции и ТО.
FUJITSU Integrated System PRIMEFLEX для SAP HANA
Эта интегрированная система по максимуму использует возможности SAP HANA. PRIMEFLEX от FUJITSU подходит для хранения и обработки больших объемов данных в оперативной памяти в режиме real time. Вычисления выполняются как локально, так и в «облаке».
Компания FUJITSU поставляет PRIMEFLEX для SAP HANA комплексно, с дополнительными услугами для всех этапов – от принятия решения по проекту и финансирования до текущих операций. Продукт создан на базе компонентов и технологий, которые прошли сертификацию для SAP. Он охватывает разные архитектуры, в том числе ранее настроенные, поддерживающие масштабирование системы, индивидуальные и виртуализированные платформы VMware.
Компания ITELON предлагает услуги по разработке решений для Big Data. Мы грамотно интегрируем ПО для работы с большими данными и органично внедрим его в ваши бизнес-процессы так, чтобы технологии и инструменты дополняли друг друга и делали компанию более конкурентоспособной.
На схеме Текстом
Обзор Что такое VVV? Где используется Big Data Как выглядит работа с Big Data? Как выбрать платформу для работы с Big Data?
Источник: itelon.ru
Big Data: перспективы развития, тренды и объемы рынка больших данных
Большие данные представляют собой массивы информации, характеризующиеся колоссальными объемами, стремительно растущей скоростью накопления, разнообразием их формата представления как в виде структурированной, так и неструктурированной информации. Big Data также включают в себя комплекс инновационных методов и способов хранения и обработки информации с целью автоматизации, оптимизации бизнес-процессов, обеспечения принятия наиболее эффективных решений на основе накопленной информации.
Принять участие в опросе
Таким образом, большие данные характеризуются тремя основными признаками:
- большой объем информации,
- высокая скорость изменения информации,
- разнообразие и разнородность данных.
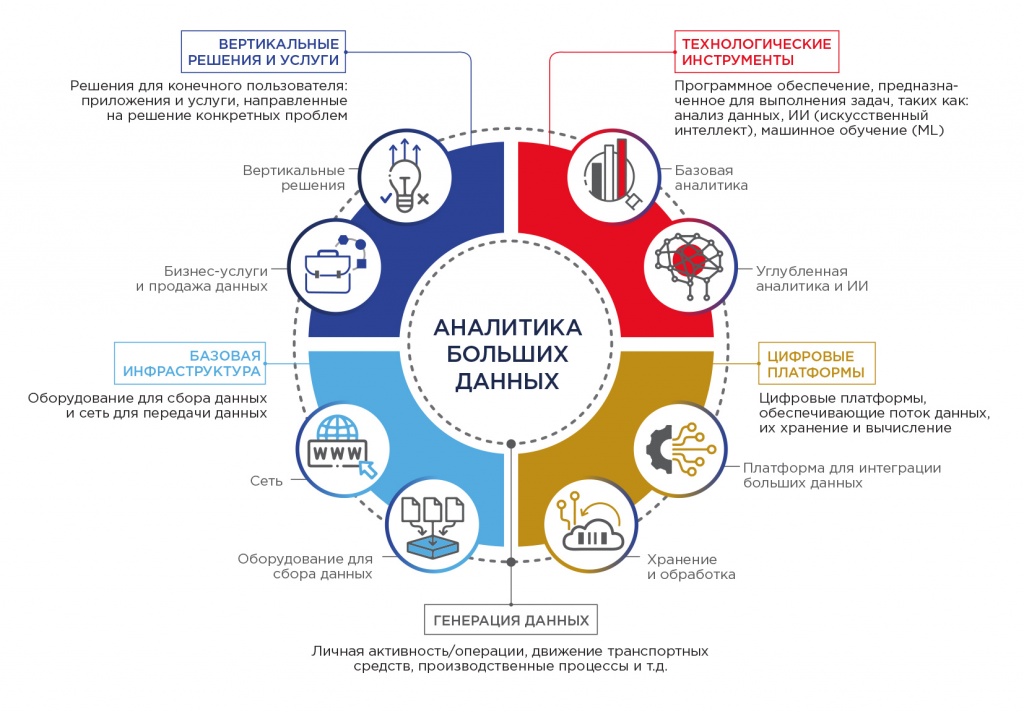
Ниже представлены ключевые элементы, составляющие аналитику больших данных.
Рис. 1. Ключевые элементы, составляющие аналитику больших данных
Структура и объем рынка больших данных
В 2018 году объем глобального рынка Big Data и бизнес-аналитики (global big data and business analytics market) достиг 168,8 млрд долл. В соответствии с оценкой IDC, по итогам 2019 года объем глобального рынка больших данных увеличился на 12%, по сравнению с показателями предыдущего года, и достиг 189,1 млрд долл. Кроме того, в период 2018-2022 гг. предполагается рост рынка со среднегодовым темпом (CAGR) на уровне 13,2%. Таким образом, объем рынка может увеличиться до 274,3 млрд долл. к 2022 году.
ResearchAndMarkets прогнозирует возможные темпы роста глобального рынка Big data на уровне 19,7% ежегодно на период 2019-2025 гг.
Рис. 2. Динамика роста рынка больших данных, млрд долл.
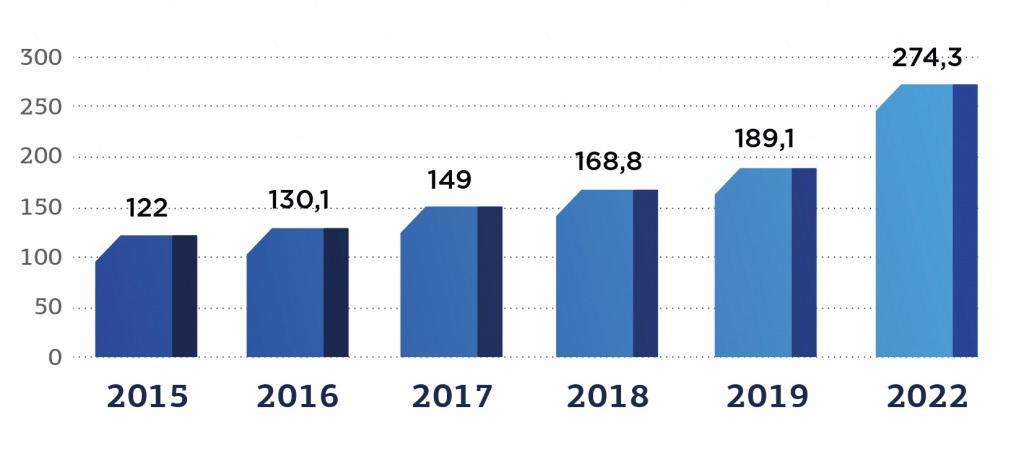
Источник: Global big data and business analytics revenue from 2015 to 2022: https://www.statista.com
В 2018 году выручка на рынке программного обеспечения больших данных составила 60,7 млрд долл. На конец 2019 года более половины выручки BDA обеспечили доходы, полученные от IT- и бизнес-сервисов – 77,5 млрд долл. и 20,7 млрд долл. соответственно. Размер выручки в сегменте аппаратного обеспечения составил около 23,7 млрд долл. Доход от программного обеспечения больших данных достиг 67,2 млрд долл. По данным IDC, ожидаемые темпы роста (CAGR) в период с 2018-2023 гг. в этом сегменте поднимутся до отметки в 12,5%.
Согласно исследованию Fortune Business Insights, объем глобального рынка технологий Big Datа, оцененный в 2018 году в 38,6 млрд долл., увеличится к 2026 году до 104,3 млрд долл., демонстрируя темпы роста (CAGR) на уровне 14% в период с 2019 по 2026 гг.
Рис. 3. Доля сегментов рынка в общем объеме выручки, %
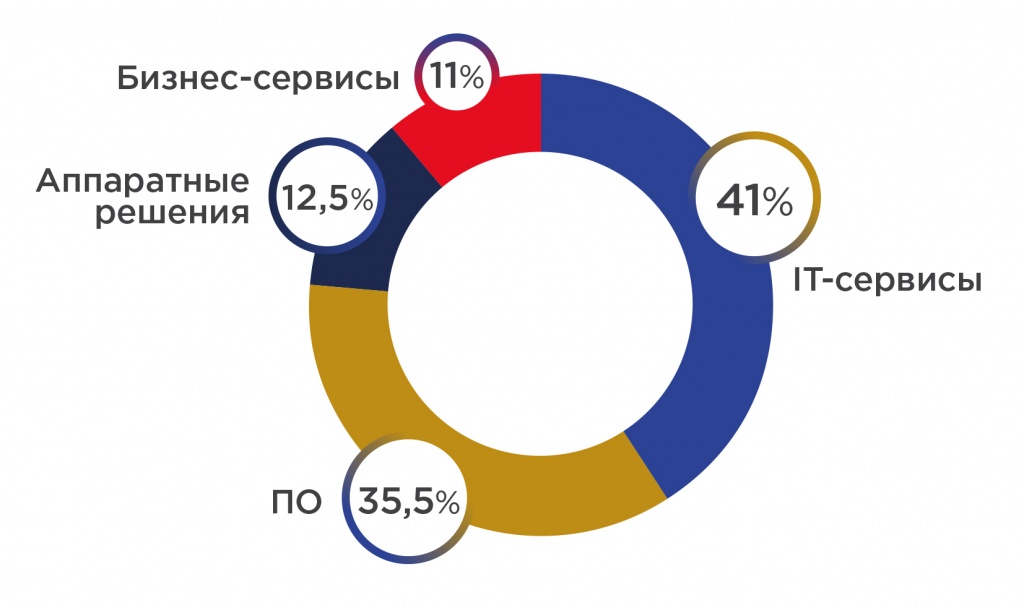
Источник: Big Data Technology Market Size, Share, Demand D – «песочницы» для исследования БД
5.Стратегия БД традиционных индустрий
2.Обеспечение возможности обмена/обогащения данных
4.Финансирование инноваций и ресурсная экосистема
6.Внутренние стимулы для инновационных отраслей
Платформы для крупномасштабного обмена данными
Специализированные государственные инвестиционные программы
Финансовая поддержка экспорта
Источник: Российские сценарии для Big Data: https://rspectr.com
Реализация стратегии развития российского рынка Big Data
АБД будет продвигать 6 инициатив: 3 дадут умеренный эффект, остальные – более агрессивные по сложности имплементации и эффекту от БД.
Умеренный эффект:
1. Упрощенный доступ и обработка данных
- Позволить пользователям одновременно и дистанционно давать согласие на несколько целей использования их данных;
- Позволить компаниям обрабатывать персональные данные для широкого круга целей при соблюдении определенных требований;
- Запустить массовую государственную цифровизацию в областях, релевантных для БД, с фокусом на стандартизацию данных.
3. R
5. Стратегии Больших Данных традиционных индустрий
- Создать стандарт для внедрения Больших Данных в компании с государственным участием;
- Ввести ориентированные на результат стимулы для компаний частного сектора;
- Создать проектный и технический кадровый резерв, чтобы помочь компаниям внедрять Большие Данные и обучать их команды.
Агрессивный эффект:
2. Обеспечение возможности обмена/обогащения данных
- Позволить игрокам делиться анонимными персональными данными на коммерческой основе;
- Поощрять обмен отраслевыми данными внутри и между отраслями через саморегулируемые стандарты;
- Позволить государству делиться определенными типами релевантных данных с частным сектором.
4. Финансирование инноваций и ресурсная экосистема
- Обеспечить инновационные команды выделенным доступом к «озерам данных» с труднодоступной отраслевой информацией;
- Оптимизировать процессы бэк-офисного типа путем предоставления доступа к юристам, бухгалтерам и специалистам по патентам;
- Внедрить инвестиционную платформу, соединяющую квалифицированных инвесторов с отобранными инициативами.
6. Внутренние стимулы для инновационных отраслей
- Внедрить упрощенный процесс получения необходимых сертификатов и патентов для продуктов и услуг на основе Больших Данных;
- Устранить выборочные барьеры для экспорта продуктов и сервисов, построенных на технологиях Больших Данных;
- Провести кампании по повышению осведомленности об экспортном потенциале продуктов на технологиях Больших Данных.
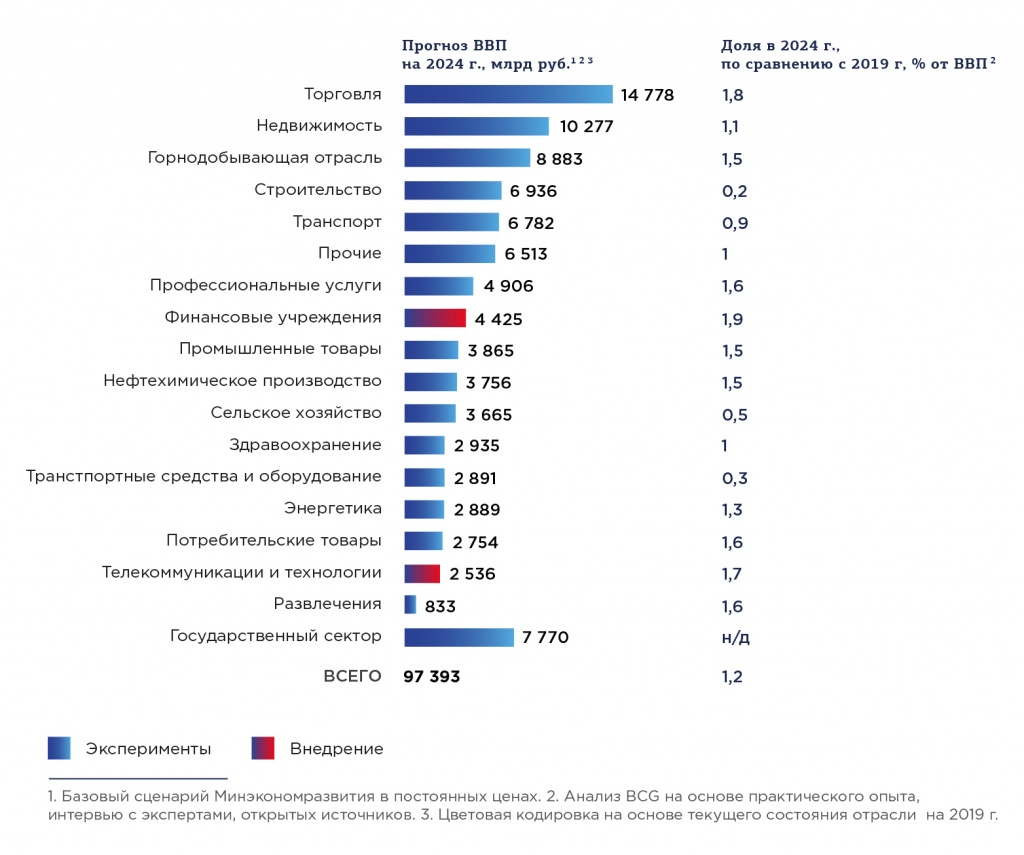
Согласно базовому сценарию, в 2024 году в России эффект от внедрения продуктов и технологий больших данных увеличится на 1,2% как доля от ВВП.
Рис. 8. Базовый сценарий эффективности внедрения инструментов больших данных
Источник: Минэкономразвития РФ
Меры, направленные на реализацию стратегии, объединены в три основных блока:
- повышение доступности данных,
- проведение исследований в области больших данных (RD – «песочницы» для проведения экспериментов, внедрения мер по изменению законодательства, центра компетенций и др.
Согласно прогнозу IDC, к 2025 году общий объем цифровых данных, генерируемых во всем мире, вырастет более чем вчетверо – до 175 Зеттабайт с 40 Зеттабайт в 2020 году, в том числе благодаря растущему количеству IoT-устройств и датчиков. В соответствии с описанием главных атрибутов больших данных как «трех «V» (объем, многообразие, скорость), которое дает Gartner, эта нарастающая лавина данных будет все больше характеризоваться разнообразием типов информации, причем большая часть будет представлять собой постоянно меняющиеся потоки данных в реальном времени. Как результат, задача управления данными и их анализа значительно затрудняется. И это обусловливает многие из трендов, которые, по всей видимости, будут преобладать в ближайшие три года.
Ключевые технологические тренды Big Data
Gartner отмечает следующие 11 технологических трендов в области данных и аналитики, которые потенциально окажут значительное влияние на дальнейшее развитие рынка в течение последующих 3-5 лет:
Технологический тренд Описание «Расширенная» (дополненная) аналитика (Augmented analytics) Совершенствование процесса анализа за счет автоматизации процесса поиска, обработки данных с использованием технологий машинного обучения (Machine Learning (ML)) и искусственного интеллекта (Artificial Intelligence (AI)). Отмечается, что к 2020 году расширенная аналитика станет драйвером в области закупок инструментов бизнес-аналитики, а также платформ обработки информации. По данным ResearchAndMarkets, ожидается, что рынок расширенной аналитики вырастет с 4,8 млрд долл. в 2018 году до 18,4 млрд долл. к 2023 году при совокупном годовом темпе роста (CAGR) 30,6%. «Расширенное» (дополненное) управление данными (Augmented data management) Применение технологий AI и ML, позволяющих осуществлять автоматизацию и самонастройку процесса управления корпоративными данными (включая управление метаданными, качеством данных, интеграцию данных и баз данных). К 2022 году предполагается снижение объема «ручного» управления данными компаний на 45%. Технологии обработки естественного языка (Natural language processing (NLP) and conversational analytics) Согласно прогнозу экспертов, к 2021 году внедрение средств NLP повысит уровень распространения технологий интеллектуального анализа данных с 35% до 50%. Технология обработки естественного языка позволяет компьютерам понимать человека. Как результат, рядовые бизнес-пользователи смогут делать запросы к сложным массивам данных обычными словами и фразами – голосом или вводом с клавиатуры и получать такие же легко понимаемые результаты бизнес-анализа. По прогнозу Gartner, к концу 2020 года 50% аналитических запросов будут делаться на естественном языке или с помощью привычного поиска либо генерироваться автоматически. А по данным Ventana Research, 33% организаций ожидают, что к 2021 году запросы и ответы на естественном языке будут стандартной функцией инструментов бизнес-анализа. Аналитика графов (Graph analytics) По оценке Gartner, применение методов обработки графической информации и графических баз данных будет увеличиваться на 100% ежегодно в течение последующих 5 лет. Бизнес-аналитики создают все более сложные запросы к структурированным и неструктурированным данным, часто из нескольких приложений и источников. Выполнение таких сложных запросов в больших масштабах с использованием традиционных инструментов и языков запросов представляет собой очень трудную задачу. Графовые базы данных и инструменты аналитики и визуализации помогают справиться с этой задачей, показывая связи, существующие между узлами — людьми, локациями и объектами материального мира. Gartner прогнозирует, что использование графовой обработки и графовых баз данных будет удваиваться ежегодно в последующие несколько лет, что позволит «ускорить подготовку данных и создать более сложные и адаптивные методы анализирования данных». Коммерческие инструменты искусственного интеллекта и машинного обучения (Commercial AI and machine learning) Переход от использования платформ с открытым исходным кодом к применению специально разработанных коннекторов, подключающихся к open-source экосистеме, позволит реализовать функции управления моделями, проектами, а также предоставит возможность для преобразования и многократного использования данных, обеспечит интеграцию и прозрачность, недоступные в рамках open-source платформ. Разработчики ПО анализа данных всегда стремились предоставить возможности своей технологии более широкой аудитории обычных бизнес-пользователей и всех работающих с информацией. И это уже происходит благодаря так называемой интеллектуальной (augmented) аналитике. Gartner определяет интеллектуальную аналитику как использование технологий искусственного интеллекта, машинного обучения и обработки естественного языка для содействия в подготовке данных, понимании и трактовке результатов анализа, то есть в качестве расширения возможностей человека и традиционных способов формирования и использования аналитического контента. Интеллектуальная аналитика поможет специалистам и обычным сотрудникам, работающим с информацией, автоматизировать многие аспекты изучения данных, а также разработки и использования моделей данных. К 2022 году 75% решений для конечных пользователей будут создаваться с использованием коммерческих, а не открытых платформ. Матрица данных (Data fabric) Подходы к интеграции данных в виде логически организованной структуры для облегченного доступа и обмена в распределенной среде данных. Объясняемый искусственный интеллект (Explainable AI) Возможность формирования описательной модели на естественном языке, позволяющей обосновать автоматически сгенерированные решения и результаты, полученные на базе технологий AI. К 2023 году более 75% крупных организаций будут нанимать специалистов по поведению AI, обеспечению конфиденциальности и доверительных отношений с клиентом для снижения репутационных рисков. Блокчейн в области данных и аналитики Реализует взаимосвязь транзакций, активов, обеспечивает прозрачность и гарантии в сложных сетях взаимодействия участников. Непрерывная интеллектуальная обработка данных (Continuous Intelligence) Подход, при котором результаты аналитики в реальном времени интегрируются в бизнес-операции, происходит обработка потоковой контекстной информации, поступающей с датчиков IoT, и исторических данных, позволяющий моментально реагировать на изменения и предписывать поведение моделей. К 2020 году прогнозируется наличие функции непрерывного интеллектуального анализа в более чем 50% бизнес-систем. Серверы «постоянной» памяти (Persistent memory servers) Tехнология сохранения данных при отключении питания позволяет решить проблему ограниченности объемов памяти при возрастающем количестве данных; предоставляет возможность анализировать больше данных в оперативной памяти и в режиме реального времени; повышает энергоэффективность, операции с данными становятся более рациональными за счет уменьшения дублирования. Ужесточение регулирования в сфере обращения с данными Многие компании уже ощутили на себе ужесточение регулирования в обращении с данными с вступлением в силу Генерального регламента о защите данных (GDPR) в Евросоюзе в мае 2018 года. В 2020 году, с вводом Закона штата Калифорния о защите конфиденциальности потребителей (CCPA) и в свете растущих призывов ввести такие правила в масштабах всей страны, компании и организации в США встанут перед необходимостью внедрить строгий контроль за данными, обеспечением их защищенности и конфиденциальности. Все это окажет влияние на практику сбора, обработки, хранения и использования данных компаниями, и, в первую очередь, это касается данных потребителей. К 2021 году 25% организаций создадут новые центры передовых технологий управления данными и безопасности, что поможет снизить риск неправомерного использования или утечки, по прогнозу Ventana Research. Исследователи в сфере технологий управления данными и бизнес-анализа призваны сыграть ключевую роль в разработке и внедрении эффективных и надежных методов. Источник: delprof.ru