
Таким образом, выборочное стандартное отклонение равно квадратному корню из выборочной дисперсии, следовательно, справедливы формулы:
Пример 2.21 В течение пяти дней студент Ковалев записывал стоимость обедов в студенческой столовой: 3,2; 4,8; 5,6; 4,5; 5,4. Найдем выборочную дисперсию и стандартное отклонение.
Сначала определим среднее:
Найдем стандартное отклонение:
Округлим полученное значение: S = 0,95 условных рублей.
Определение 2.14 Выборочной дисперсией вариационного ряда x1, x2, …, xn с соответствующими частотами называется число , определяемое формулой:
соответственно, при малом и большом значении n, где .
Пример 2.22 Для социологического исследования были собраны данные о количественном составе 20 семей, приведенные в следующей таблице.
Таблица 2.16 – Количественный состав семей
Найдем среднее, дисперсию и стандартное отклонение:
n = 2 + 3 + 8 + 5 + 1 + 1 = 20;
Округлим S 2 = 1,50 и S = 1,23. Итак, – это среднее число членов семьи, S = 1,23 – это стандартное отклонение от среднего.
Индикатор Standard Deviation (Стандартное отклонение)
Определение 2.15 Выборочной дисперсией статистического ряда, состоящего из k интервалов с соответствующими интервальными средними и интервальными частотами , называется число , равное:
или ,
соответственно, при малом и большом значении n, где .
Пример 2.23 Результаты экзамена по высшей математике пятидесяти студентов представлены следующим статистическим рядом. Используется десятибалльная система оценок. Найдем среднее и стандартное отклонение.
Таблица 2.17 – Итоги экзамена по высшей математике
Найдем интервальные средние:
Найдем дисперсию данной выборки:
Определим значение стандартного отклонения:
Итак, средняя оценка студентов I курса составляет 5,6 баллов. Стандартное отклонение баллов показывает, что оценки большинства студентов отличаются от среднего не более, чем на 2,26 баллов.
Таким образом, для вычисления выборочной дисперсии необходимо найти значение среднего , вычислить сумму квадратов отклонений выборочный значений от среднего и разделить ее на n – 1, где n – число всех наблюдений. Извлечение квадратного корня при нахождении стандартного отклонения возвращает к первоначальному масштабу единицы измерения.
Обработка и анализ статических данных требует кропотливой и нелегкой вычислительной работы. Для организации вычислений в математической статистике часто используются специальные таблицы.
Пример 2.24 Найдем среднее и стандартное отклонение для статистического ряда из примера 1.4 о высоте городских зданий. Все необходимые вычисления будем записывать в таблицу 2.18.
Из таблицы 2.18 берем необходимые промежуточные результаты:
Итак, среднее высоты зданий равно 27,12 метров, а стандартное отклонение равно 9,96 метров.
Таблица 2.18 – Вычисление среднего и стандартного отклонения высоты зданий
Источник: vunivere.ru
Самый простой и понятный индикатор Standard Deviation (стандартное отклонение)!
Стандартное отклонение и стандартная ошибка
Я читаю курс статистического мышления магистрам, и одна тема вызывает у них явные затруднения – чем стандартное отклонение отличается от стандартной ошибки, и в каких случаях, применять ту или иную статистику. А недавно в книге Искусство статистики Дэвида Шпигельхалтера я узнал про бутстрэппинг, и понял, как объяснить различия стандартного отклонения и стандартной ошибки.
Для начала зададим 100 значений стандартной нормально распределенной случайной величины. В этом контексте стандартная означает, что ее матожидание μ = 0, а среднеквадратичное отклонение σ = 1. Поскольку значения в Excel получены с помощью волатильной функции СЛМАССИВ(), после любого действия они пересчитываются. Поэтому диаграммы в заметке и в файле будут отличаться.
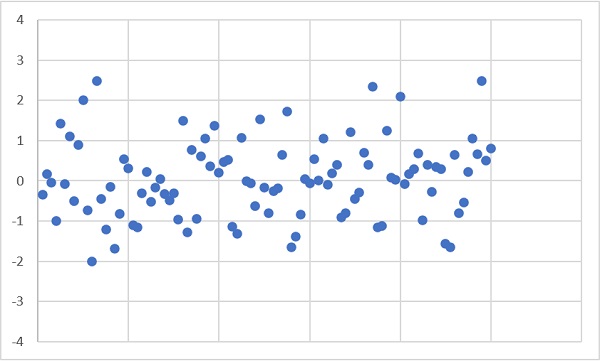
Рис. 1. Нормально распределенная случайная величина
Скачать заметку в формате Word или pdf, примеры в формате Excel
Стандартное отклонение
… является наиболее распространенным показателем рассеивания значений случайной величины относительно её среднего арифметического.
Стандартное отклонение вычисляют по формуле:
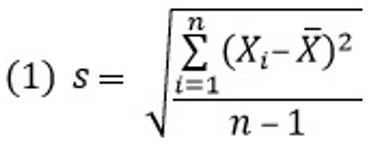
где X̅ – среднее арифметическое значений случайной величины (далее я буду называть его просто средним), Хi – отдельные значения случайной величины, n – число значений случайной величины.
Вообще термины разными авторами используются немного по-разному. Мне нравится следующий подход. Генеральную совокупность описывают параметрами, обозначаемыми греческими буквами: математическое ожидание μ и среднеквадратичное отклонение σ. Выборки описывают статистиками, обозначаемыми латинскими буквами: среднее арифметическое X̅ и стандартное отклонение s. Стандартное отклонение иначе называют оценкой среднеквадратичного отклонения. Как правило, есть генеральная совокупность с неизвестным нам среднеквадратичным отклонением σ. Извлекая выборку, и вычисляя стандартное отклонение s, мы кое-что узнаем о среднеквадратичном отклонении генеральной совокупности σ. Поэтому и говорят, что s является оценкой сигмы.
На самом деле за термином стандартное отклонение стоят две немного отличающиеся статистики. Но эта заметка о другом)) Подробнее см. СТАНДОТКЛОН.В и СТАНДОТКЛОН.Г: в чем различие?
Нанесем на диаграмму линию среднего и границы, отстоящие от среднего на расстоянии ±2s.

Рис. 2. Линия среднего и границы ±2s
Для стандартного нормального распределения за границы ±2s попадают 4,6% значений.
И действительно 5 точек на рис. 2 лежат вне границ. Совпадение не обязано быть таким точным. Если вы откроете файл Excel на листе «Рис. 2» и понажимаете F9, принудительно изменяя случайные значения, то увидите, что вне границ может лежать от 2 до 8 точек.
А если нажимать F9 достаточно долго, то вы получите более экстремальные числа точек вне границ. Для стандартного нормального распределения в пределах ±2s лежат приблизительно 95% значений. Поскольку s – оценка среднеквадратичного отклонения σ, которое в свою очередь равно 1, то 95% всех значений попадают в диапазон ≈ ±2.
Чем меньше s, тем кучнее значения случайной величины располагаются вокруг среднего. Итак
стандартное отклонение – мера разброса случайной величины
Среднее арифметическое выборки
Напомню, что мы задаем наши 100 значений с помощью генератора случайных чисел формулой в Excel
Хотя мы установили для генератора случайных чисел μ = 0 и σ = 1, значения X̅ и s будут немного отличаться для каждой выборки.
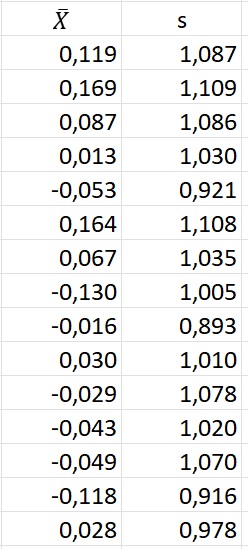
Рис. 3. Среднее и стандартное отклонение для 15 выборок размером n = 100
Теперь мы хотим узнать, что можно сказать о неизвестном математическом ожидании генеральной совокупности μ, подсчитав среднее арифметическое конкретной выборки, например, первой X̅ = 0,119?
Бутстрэп
Как пишет Евгения Поникарова, переводчик книги Дэвида Шпигельхалтера «Искусство статистики», слово bootstraps означает ремешки в виде ушка, которые прикрепляются к верхней части обуви, чтобы ее было проще натягивать. В английском языке есть выражение To pull oneself over a fence by one’s bootstraps (буквально — перетащить себя через ограду за ушки своей обуви), которое означает «выпутаться из своих проблем самому». Еще можно вспомнить барона Мюнхгаузена, который вытащил себя за волосы из болота.
Бутстрэп – компьютерный метод исследования распределения статистик, основанный на многократной генерации выборок методом Монте-Карло на базе имеющейся одной выборки. Термин ввел в 1977 году Брэдли Эфрон.
Итак, возьмем одну выборку из 100 случайных чисел и зафиксируем значения. Это наша исходная выборка (столбец А на рис. 4). Её среднее X̅(100) = 0,121, а стандартное отклонение s(100) = 0,995. 95% значений попадают в диапазон ≈ 0,121 ± 1,990.
С помощью генератора случайных чисел будем формировать из исходной выборки бутстрэп-выборки разного размера. Хитрость заключается в том, что выбирать значения мы будем с возвращением. Т.е., все значения любой бутстрэп-выборки взяты из исходной, а вот уникальность значений будет потеряна. Например, выборка в столбце С содержит два значения 0,7394.
Я подсветил их с помощью условного форматирования. Опять же, если вы откроете Excel-файл, то дублей может не быть, так как бутстрэп-выборка сформирована волатильной функцией СЛМАССИВ().
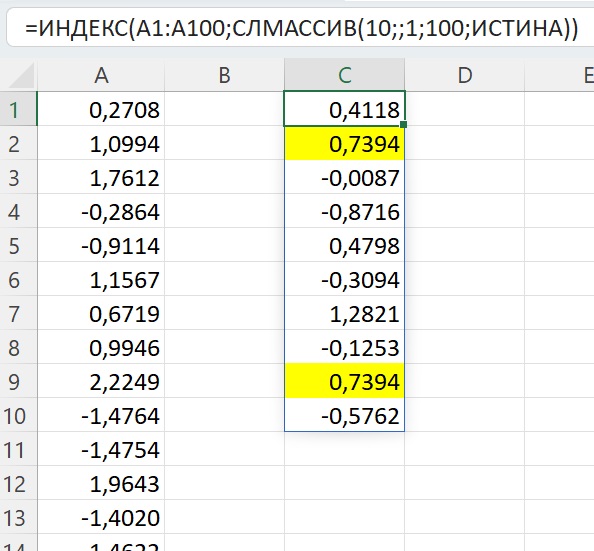
Рис. 4. Бутстрэп-выборка может содержать повторения
Для удобства последующей обработки расположим значения бутстрэп-выборки по горизонтали. Начнем со значения n = 3. Извлечем 1000 бутстрэп-выборок (рис. 5). В столбце А исходная выборка, n = 100. Столбец С содержит номер бутстрэп-выборки.
В столбцах D, E и F извлеченные значения, в G – средние значения по выборкам. В ячейке G1 среднее D1:F1, в ячейке G2 – среднее D2:F2 и т.д. На диаграмме показано распределение средних значений бутстрэп-выборок для n = 3.
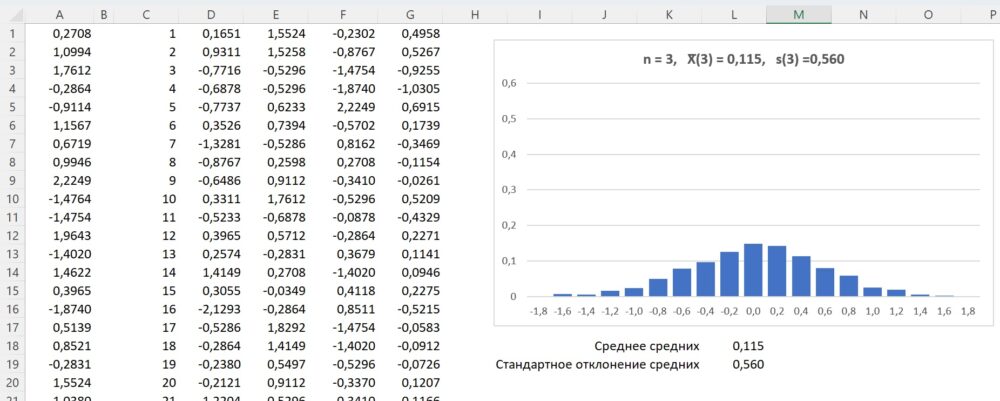
Рис. 5. Распределений средних значений 1000 бутстрэп-выборок, n = 3
Среднее средних 1000 бутстрэп-выборок = 0,115, стандартное отклонение средних значений 1000 бутстрэп-выборок = 0,560. Напоминаю, что 95% исходных значений выборки попадают в диапазон 0,12 ± 1,99. Для бутстрэп-выборок n = 3 мы только что нашли, что 95% средних попадают в диапазон 0,115 ± 1,120 (0,560*2 = 1,120). Кажется естественным, что разброс средних меньше, чем разброс отдельных значений.
Повторим моделирование для n = 5, 20, 50.
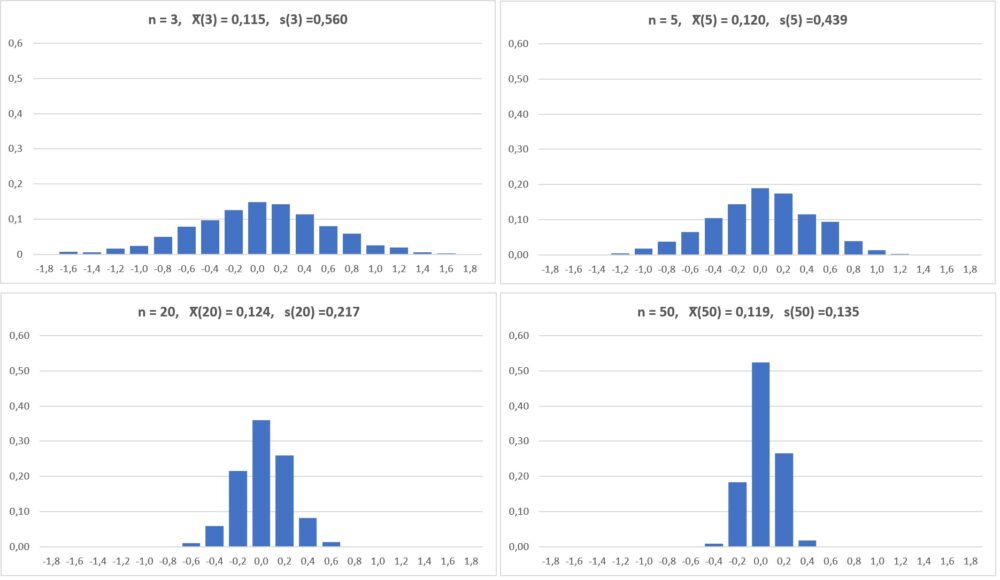
Рис. 6. С увеличением n стандартное отклонение средних значений бутстрэп-выборок уменьшается
Осмыслим, что мы получили. На рис. 6 представлены распределения средних значений бутстрэп-выборок разного размера из исходной выборки 100 случайных нормально распределенных чисел. Среднее каждого распределения близко к нулю (в нашей конкретной выборке из 100 чисел это среднее равно 0,121). А вот стандартное отклонение s(n) уменьшается по мере роста размера бутстрэп-выборок: s(3) = 0,560, s(5) = 0,439, s(20) = 0,217, s(50) = 0,135.
Стандартна ошибка
…или стандартная ошибка среднего – статистика, характеризующая стандартное отклонение выборочного среднего, рассчитанное по выборке размера n из генеральной совокупности.
Ничего не напоминает!? А что за статистику s(n) мы рассчитали выше в бутстрэп-анализе!? Да, это было стандартное отклонение выборочного среднего X̅(n).
Величина стандартной ошибки зависит от дисперсии генеральной совокупности σ 2 и объёма выборки n. Стандартная ошибка среднего вычисляется по формуле

где σ – величина среднеквадратического отклонения генеральной совокупности, и n – объём выборки. Поскольку дисперсия генеральной совокупности, как правило, неизвестна, то оценка стандартной ошибки вычисляется по формуле:

где s — стандартное отклонение случайной величины.
Сведем в одной таблице рассмотренные статистики:

Рис. 7. Рассмотренные статистики
Здесь в столбцах J:L приведены статистики для одной выборки размера n, а в столбце M – статистики для бутстрэп-выборок соответствующего размера с рис. 6. Если в Excel-файле на листе «Рис. 7» понажимать F9, вы увидите, что не всегда совпадение между столбцами L и M будет таким хорошим, но тенденция будет прослеживаться.
Выше я писал, что мы исследуем неизвестное математическое ожидание генеральной совокупности μ на основе среднего арифметического выборки X̅(100) = 0,119.
Расчет среднего квадратичного отклонения в Microsoft Excel
Одним из основных инструментов статистического анализа является расчет среднего квадратичного отклонения. Данный показатель позволяет сделать оценку стандартного отклонения по выборке или по генеральной совокупности. Давайте узнаем, как использовать формулу определения среднеквадратичного отклонения в Excel.
Определение среднего квадратичного отклонения
Сразу определим, что же представляет собой среднеквадратичное отклонение и как выглядит его формула. Эта величина является корнем квадратным из среднего арифметического числа квадратов разности всех величин ряда и их среднего арифметического. Существует тождественное наименование данного показателя — стандартное отклонение. Оба названия полностью равнозначны.
Но, естественно, что в Экселе пользователю не приходится это высчитывать, так как за него все делает программа. Давайте узнаем, как посчитать стандартное отклонение в Excel.
Расчет в Excel
Рассчитать указанную величину в Экселе можно с помощью двух специальных функций СТАНДОТКЛОН.В (по выборочной совокупности) и СТАНДОТКЛОН.Г (по генеральной совокупности). Принцип их действия абсолютно одинаков, но вызвать их можно тремя способами, о которых мы поговорим ниже.
Способ 1: мастер функций
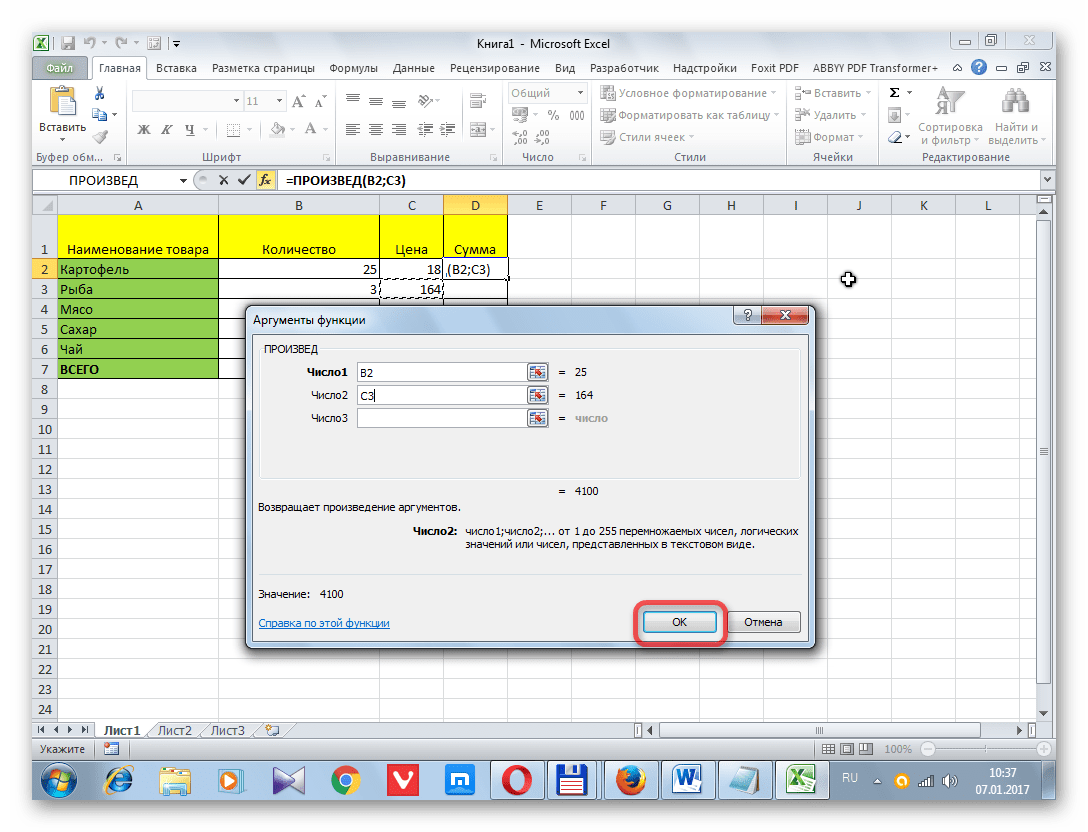
- Выделяем на листе ячейку, куда будет выводиться готовый результат. Кликаем на кнопку «Вставить функцию», расположенную слева от строки функций.
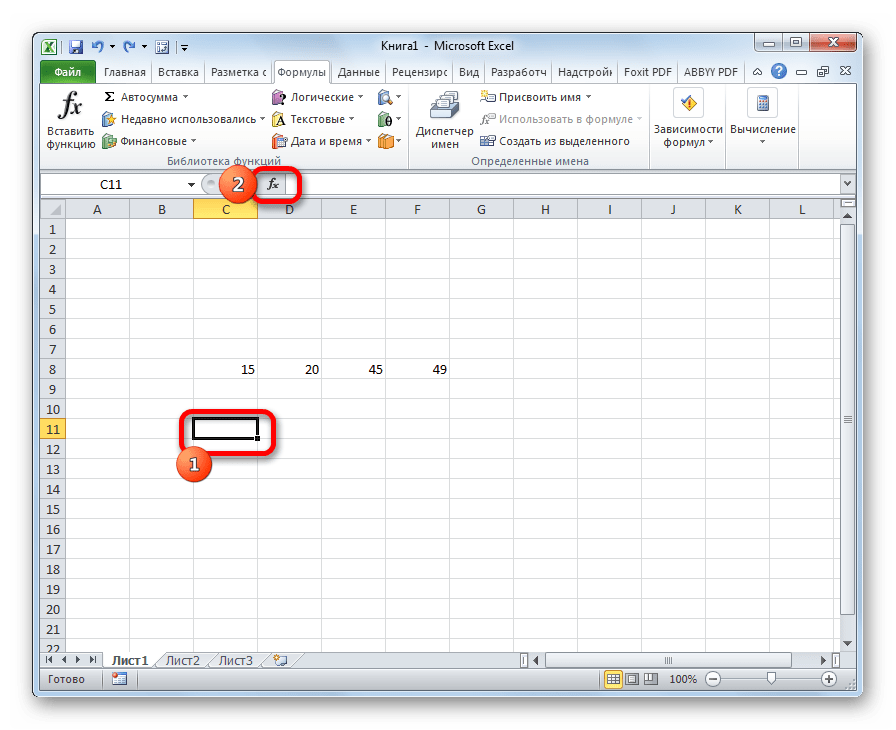
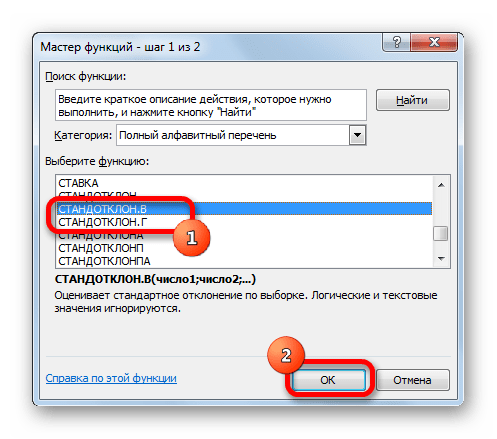
- В открывшемся списке ищем запись СТАНДОТКЛОН.В или СТАНДОТКЛОН.Г. В списке имеется также функция СТАНДОТКЛОН, но она оставлена из предыдущих версий Excel в целях совместимости. После того, как запись выбрана, жмем на кнопку «OK».
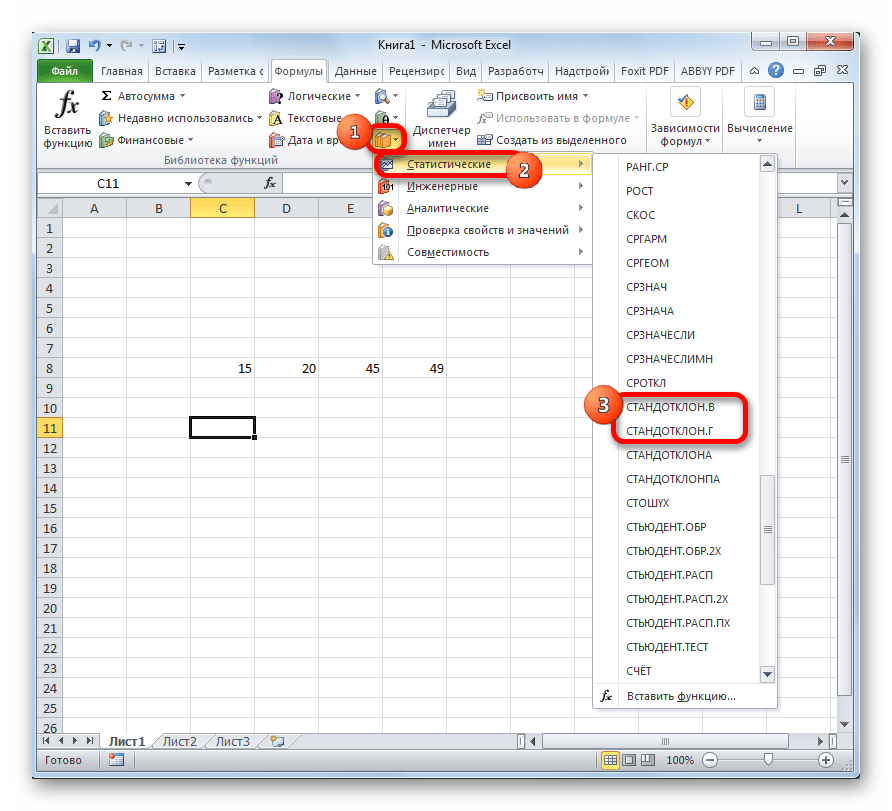
Способ 2: вкладка «Формулы»
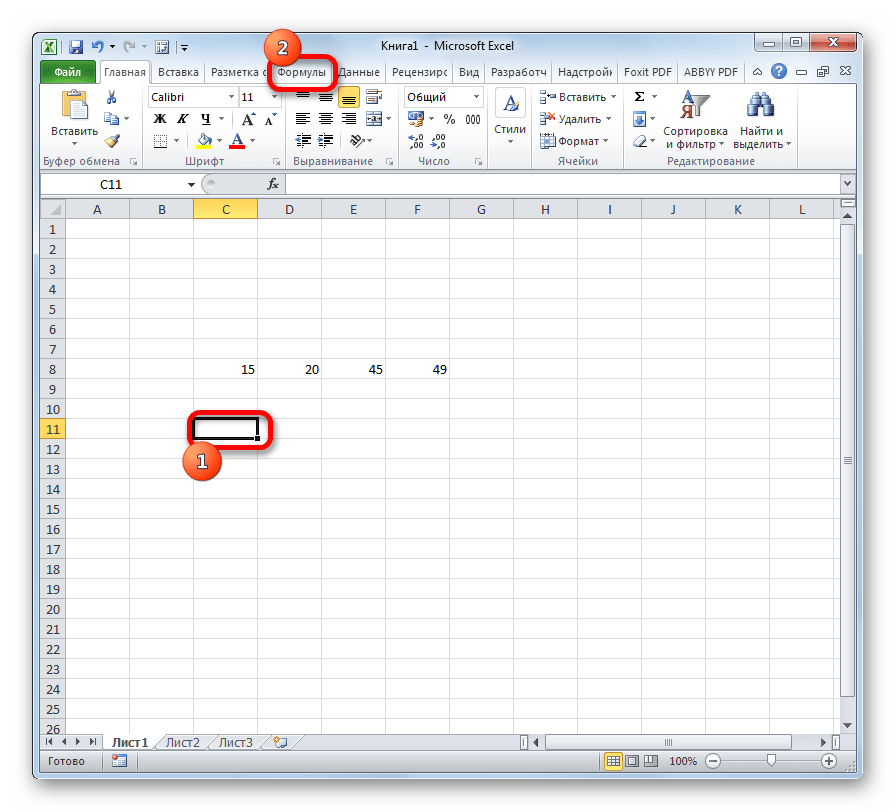
Также рассчитать значение среднеквадратичного отклонения можно через вкладку «Формулы».
-
Выделяем ячейку для вывода результата и переходим во вкладку «Формулы».
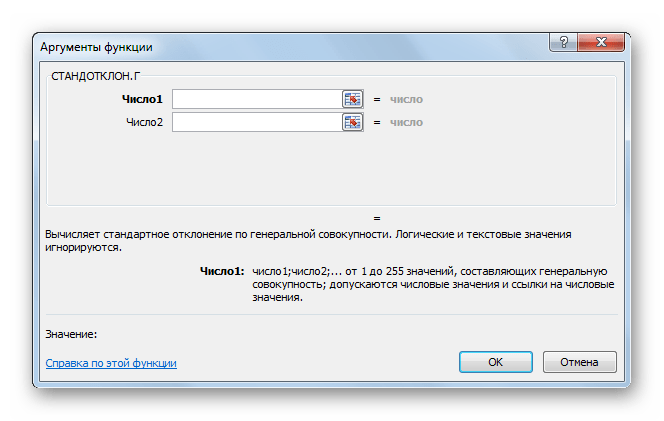
Способ 3: ручной ввод формулы
Существует также способ, при котором вообще не нужно будет вызывать окно аргументов. Для этого следует ввести формулу вручную.
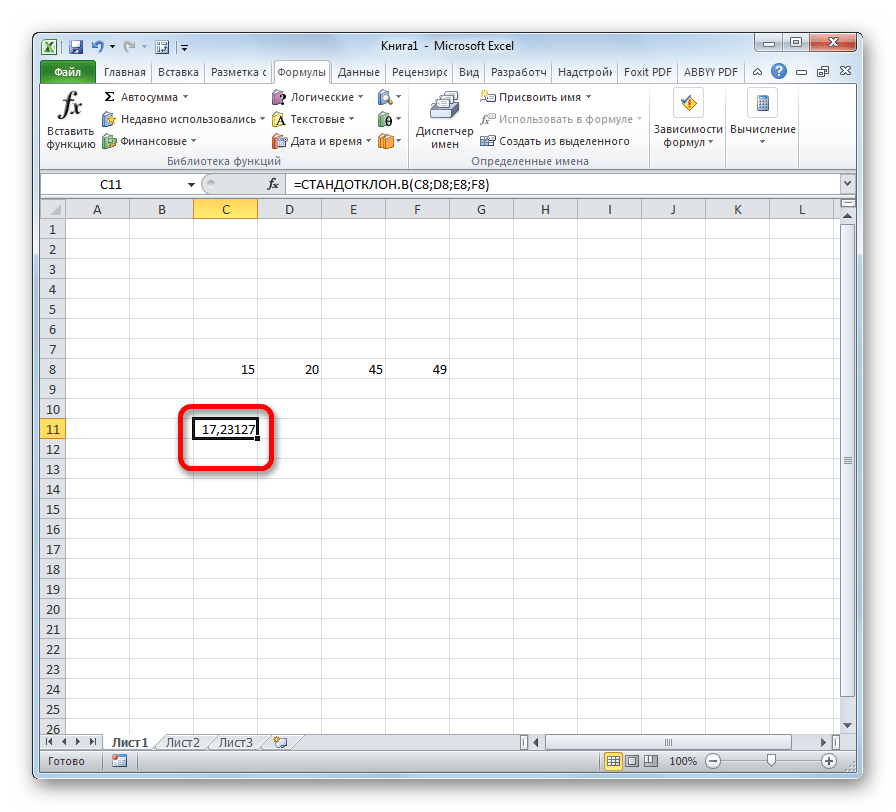
- Выделяем ячейку для вывода результата и прописываем в ней или в строке формул выражение по следующему шаблону: =СТАНДОТКЛОН.Г(число1(адрес_ячейки1); число2(адрес_ячейки2);…)
или
=СТАНДОТКЛОН.В(число1(адрес_ячейки1); число2(адрес_ячейки2);…). Всего можно записать при необходимости до 255 аргументов.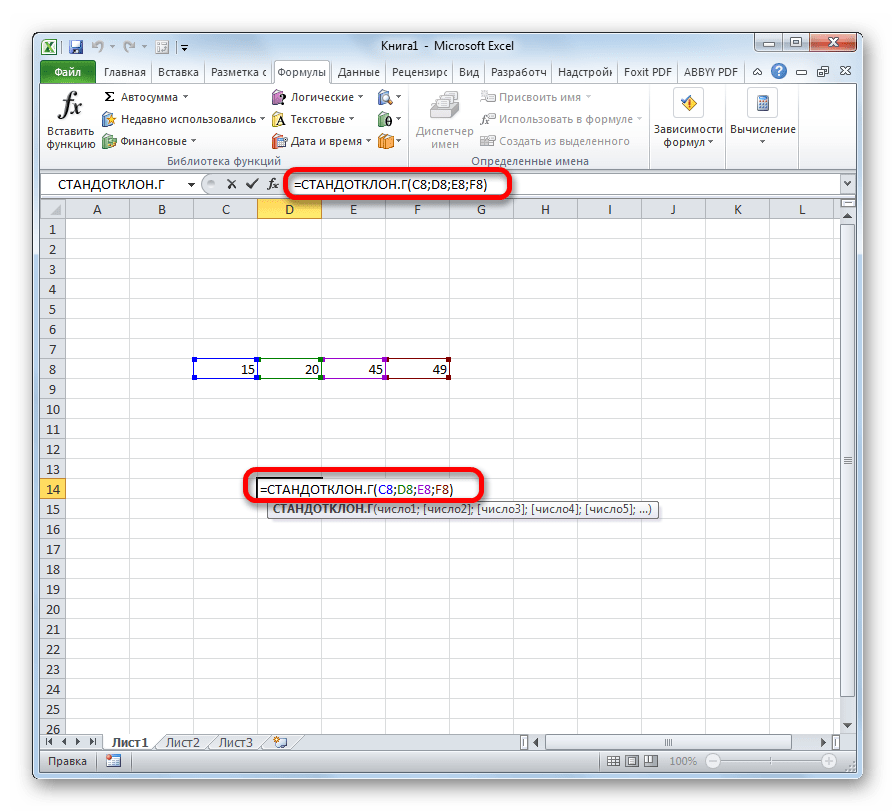
- После того, как запись сделана, нажмите на кнопку Enter на клавиатуре.
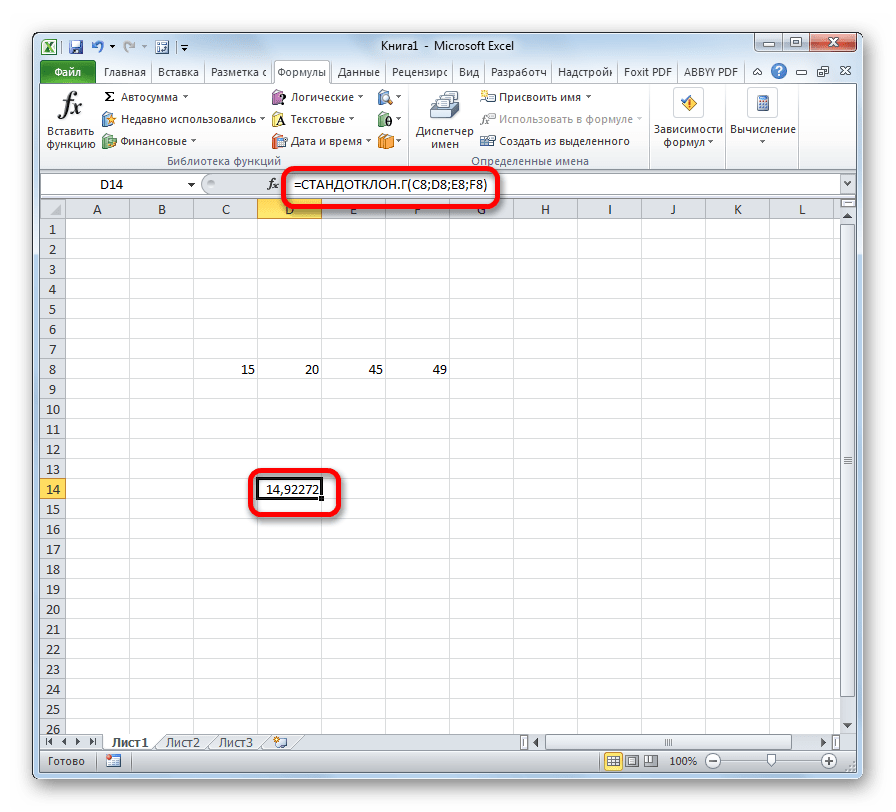
Как видим, механизм расчета среднеквадратичного отклонения в Excel очень простой. Пользователю нужно только ввести числа из совокупности или ссылки на ячейки, которые их содержат. Все расчеты выполняет сама программа. Намного сложнее осознать, что же собой представляет рассчитываемый показатель и как результаты расчета можно применить на практике. Но постижение этого уже относится больше к сфере статистики, чем к обучению работе с программным обеспечением.
Источник: lumpics.ru