
Что делает современный человек, если у него возникла потребность в какой-либо услуге? Как правило, сначала он спрашивает у друзей и знакомых, нет ли у них на примете нужных ему мастеров. И часто делает это через соцсети, размещая соответствующий пост у себя на страницах. Многие предприниматели охотятся за такими запросами в соцсетях вручную – через поиск или с помощью хэштегов.
Но можно за вполне посильную плату воспользоваться услугами специальных сервисов. О том, где «прячутся» лиды и как их заполучить, порталу Biz360.ru рассказал сооснователь сервиса Shikari Вадим Шемаров.
Вадим Шемаров, 54 года, сооснователь сервиса поиска лидов в соцсетях Shikari . Окончил Чувашский госуниверситет по специальности «технологии электроаппаратостроения», но, ещё будучи студентом, увлекся программированием, и это стало его профессией. Большую часть времени работает в качестве менеджера проектов по разработке программных продуктов (в найме). В 2015 году он и его коллеги Дмитрий Афутин и Вячеслав Сатеев создали проект Shikari.
6000 рублей с помощью нейронных сетей Лёгкая ниша для заработка на дому

Охотники за лидами
Последние несколько лет значительная часть работы Вадима Шемарова и его коллег Дмитрия Афутина и Вячеслава Сатеева была связана с мониторингом соцсетей. В 2015 году Дмитрий Афутин обратил внимание на то, что постов на тему «порекомендуйте проверенных исполнителей» (например, ремонтников, нянь, дизайнеров и т.д.) становится всё больше. Это соотносится и с мировой тенденцией: сегодня люди предпочитают решать все свои проблемы с помощью соцсетей. При таких условиях серьёзное преимущество получает тот, кто сможет «выловить» из соцсетей такие объявления.
Но два года назад большинство сервисов мониторинга соцсетей были ориентированы, как правило, на крупный бизнес. Тогда коллеги-разработчики и решили создать сервис, который бы искал в соцсетях потенциальных клиентов для определённых категорий малого бизнеса.
Для названия выбрали английское слово «shikari», которое пришло из колониальной Индии. «Шикари» означает «охотник-проводник из местных жителей». «Поскольку мы занимаемся охотой за лидами, то посчитали такое название подходящим», — говорит Вадим.
Так как все три основатели проекта – разработчики, новый продукт они создавали самостоятельно, тратиться на привлечение сторонних специалистов не пришлось. Основатели Shikari начали с составления шаблонов запросов о поиске исполнителей, которые сгруппировали в несколько категорий по сферам деятельности.
«Мы прекрасно понимали, что человек может сам составить поисковый запрос. Например, если вы репетитор, то можете ввести запрос и найти в соцсетях людей, которые ищут репетиторов. Но вариантов объявлений о поиске репетитора множество. И само объявление не раскладывается на два-три ключевых слова, которые нужно найти. Поэтому при самостоятельном поиске льётся очень много спама», — объясняет Вадим Шемаров.

Первыми пользователями стали знакомые основателей проекта. Сервис им понравился, и в начале 2016 года его создатели решили выходить со своим продуктом на рынок. Весной 2016 года состоялся коммерческий запуск проекта: сайт shikari.do начал свою работу в режиме подписки. Разработка и развитие сервиса финансировались из личных средств основателей проекта. Объём вложений Вадим Шемаров оценить затрудняется.
Как научить машину поиску
Уже на этапе тестирования стало понятно, что одного поиска по ключевым словам совершенно недостаточно. Для нахождения каждой категории лидов разработчики составляли большие поисковые запросы, но в результатах отбора было много нерелевантной (не соответствующей цели поиска) информации.
«К примеру, «Нужен фотограф!» и «Нужен фотограф?» – это объявления с совершенно разными целями. Но по тексту они абсолютно схожи, и поисковики на них реагируют одинаково», — приводит пример Вадим Шемаров.
Тогда для фильтрации найденных по ключевым словам объявлений создатели сервиса начали использовать нейронные сети. Нейросеть — это программа, состоящая из множества внутренних подпрограмм-нейронов. Сначала её нужно «обучить», чтобы она поняла, какие тексты подходят под нужную категорию, а какие не подходят.
Чем больше примеров для обучения нейросети – тем более точный результат она даёт на выходе. Для «обучения» нейросетей наняли сотрудников, которые обрабатывают запросы из соцсетей. Их задача – отметить, насколько релевантен каждый запрос, то есть в какой степени он является объявлением о поиске исполнителя.
«Обучение нейросетей можно сравнить с тем, как маленького ребёнка учат различать собачку и кошку. Они вроде похожи: четыре лапки, ушки, хвостик. Но между ними есть и отличия, которые сразу и не объяснишь. Ребёнку показывают разных кошек и собачек или их изображения. И у него в процессе обучения возникают взаимосвязи в мозге.
Постепенно он обучается определять, где кошка, а где собака. Так же и с нейросетями», — рассказывает Вадим.
Процесс машинного обучения продолжается в сервисе Shikari и сейчас. Он происходит с помощью платформы, разработанной специально для этих целей. «Обучающий корпус» Shikari (варианты объявлений, которые учитываются нейросетями) составляет уже почти 200 000 примеров.
В настоящий момент подписчики сервиса Shikari ежемесячно получают порядка 1 млн. лидов по 23 сферам деятельности
Сейчас запуск новой категории (сферы деятельности) занимает гораздо меньше времени, чем раньше. «Когда мы научились фильтровать запросы с помощью нейросетей, дело пошло гораздо лучше. Качество лидов, которые получает подписчик, увеличилось на несколько порядков. Когда мы говорим о качестве лидов, понятно, что среди отобранных объявлений есть не совсем релевантные. На 100% это невозможно обеспечить, но число ненужных объявлений можно свести к приемлемому минимуму», — считает Вадим Шемаров.
Поиск лидов с помощью сервиса Shikari выглядит следующим образом. Система выдаёт на внутренний виртуальный «конвейер» посты, найденные в соцсетях по заданным ключевым словам. После этого специально обученная нейронная сеть определяет, соответствует ли сообщение критериям поиска. Если объявление признаётся релевантным, его помещают в подходящую ему категорию. Подписчик получает в личном кабинете на сайте отобранные лиды.
Как правило, система находит объявления в течение 10 минут после их публикации. Число объявлений в месяц, которое в итоге получают подписчики сервиса, приближается к миллиону.
Клиенты и категории
Основная часть клиентов Shikari – малый бизнес (вплоть до микробизнеса). Среди подписчиков немало фрилансеров и индивидуальных «самозанятых» предпринимателей.
Самой первой сферой деятельности, выделенной на сервисе в отдельную категорию, стала фото- и видеосъёмка. Она и сейчас остаётся одной из наиболее активных категорий с большим количеством подписчиков. Фотографов приглашают на мероприятия, а также на съёмку для интернет-магазинов. Но конкуренция среди специалистов высокая, и получить достаточное количество заказов только «по рекомендациям» нелегко. Поэтому практически все фотографы сегодня ищут себе клиентов через соцсети.

Вторая по количеству подписчиков категория – дизайн сайтов, логотипов, макетов для полиграфии. В отличие от фотографов, выезжающих на съёмки в своём городе или регионе, дизайнер может работать удалённо, поэтому круг поиска заказчиков у него шире. В этой категории много и запросов, и предложений со стороны дизайнеров.
Сравнительно молодая категория – продвижение сайтов и групп в соцсетях. «Многие владельцы бизнеса пробовали обучаться, чтобы продвигать свой бизнес самостоятельно. Но теперь они говорят: «Я лучше буду заниматься своим делом, а на продвижение найму кого-то со стороны». В направлении продвижения заметен рост с обеих сторон. Растёт количество и заявок, и исполнителей», — констатирует Вадим.
Новые категории создаются на основе анализа соцсетей. Так, во время подобного мониторинга было выявлено множество запросов, связанных с поиском работы в качестве моделей. Это стало причиной открытия категории «модели».
«Для создания новой категории мало одной лишь потребности в услуге со стороны пользователей соцсетей. Нужно, чтобы исполнителей было достаточно, так как мы продаём подписки именно им», — замечает Вадим Шемаров.
Подписка и цены
На сервис Shikari можно оформить подписку разной длительности – от 3 дней до 1 года. Первая трёхдневная подписка предоставляется каждому пользователю бесплатно, в дальнейшем её стоимость составляет 120 рублей. Таких краткосрочных подписчиков у сервиса достаточно много. Основатели проекта объясняют это тем, что такие пользователи хотят найти себе всего один заказ.
Но большинство клиентов оформляют более длительную подписку – от месяца до года. Месяц пользования сервисом стоит от 700 до 900 рублей в зависимости от продолжительности подписки. Эта цена может быть и ниже в зависимости от действующей акции. Время от времени подписчикам предлагаются скидки либо бонусные периоды (к примеру, 5 месяцев при оплате за 3). Для тех, кто оплачивает новую подписку до окончания действующей, предусмотрены дополнительные скидки.
Сейчас у сервиса Shikari около 20 тысяч зарегистрированных подписчиков
В июле 2017 года у сервиса появилась новая услуга – «продвинутая» подписка. Её используют для поиска по узкоспециализированным тематикам, а также по категориям, не представленным на Shikari.
Параметры и категории поиска по социальным сетям в этом случае клиент настраивает сам, исходя из своих требований. Сначала ему нужно задать ключевые слова для поиска. После этого он включает фильтр поиска, который отбирает сообщения с выраженным в них желанием найти товар или исполнителя. Менять настройки можно так часто, как захочет сам пользователь.
В рамках этой подписки можно не включать фильтр и организовать «простой» поиск по ключевым словам. Так обычно делают не для поиска клиентов, а для отслеживания упоминаний бренда, названий и т.п.
Стоимость подписки с расширенными возможностями – от 2200 до 2900 рублей в месяц, в зависимости от её продолжительности. Помимо денег «продвинутый» подписчик должен потратить время и усилия на поиск ключевых слов и их комбинаций. Таких клиентов у Shikari пока немного. Создатели сервиса связывают это с тем, что данная услуга ещё фактически не рекламировалась. Её развитию и продвижению они намерены уделить в ближайшее время более серьёзное внимание.
Сарафанное радио не сработало
Основным каналом поиска новых подписчиков Shikari стали страницы в «ВКонтакте». В этой соцсети основатели проекта завели несколько тематических групп: для фотографов, дизайнеров, IT-специалистов и других. Все «профильные» объявления, которые находит сервис, спустя несколько дней публикуются в соответствующих группах. Таким образом, посетители групп видят там реальные объявления, отобранные программой. Если автор объявления к этому времени ещё не определился с исполнителем, пользователи вполне могут предложить свои услуги.
Такие же группы проекта по сферам деятельности существуют и в Facebook. Помимо найденных объявлений в них публикуются материалы о проекте Shikari и принципах его работы. Как показывает практика, большинство подписчиков сервиса узнают о нём именно через соцсети.
Небольшой поток клиентов приносят партнёрские программы. У Shikari есть несколько партнёров, которые работают в смежных с проектом сферах и рекламируют сервис своим клиентам. К примеру, одна из таких компаний-партнёров занимается организацией свадеб.
«Сотрудничество даёт неплохие результаты. Но в некоторых сферах нам не удалось договориться о подобном взаимодействии – мы бы конкурировали с партнёрами за клиентов и оттягивали друг у друга трафик», — рассказывает Вадим Шемаров.

По рекомендациям от других пользователей приходит не так много клиентов, как ожидали основатели проекта. Основная причина, по которой довольные сервисом подписчики не хотят рекомендовать его своим коллегам – нежелание усиливать конкуренцию в своей категории. По этой же причине они редко пишут о сервисе на своих страницах в соцсетях.
Чтобы подстегнуть активность пользователей в этом направлении, Shikari провёл конкурс среди подписчиков. Все авторы отзыWow о сервисе в соцсетях становились участниками лотереи, в которой разыгрывался смартфон. Но участников набралось немного. Некоторые подписчики на вопросы основателей сервиса отвечали прямо: «Если расскажем о вас в соцсетях – наплодим себе конкурентов. А на смартфон я себе с помощью вашего сервиса и сам заработаю».
«Мы считали, что достаточно сделать качественный сервис – и довольные клиенты будут рекомендовать нас своим знакомым. Но оказалось, что связка «хороший сервис – довольные клиенты – сарафанное радио» работает далеко не всегда», — рассуждает Вадим.
Конкуренция за лиды
Каждый день сервис Shikari находит около 10 млн. объявлений из соцсетей, блогов и форумов. Но в ленту подписчиков поступает не более 0,3% из них. По мнению основателей проекта, это свидетельствует о хорошей работе систем фильтрации.
Общее число зарегистрированных подписчиков – около 20 000. В зависимости от категории до 50-60% клиентов, оплативших первую подписку, продолжают сотрудничество с сервисом.
«Для меня это очень хорошая цифра. Я ожидал, что будет меньше. Иногда я слышу от подписчиков: «По найденным вами объявлениям мне ничего не удалось продать. Они вообще реальны?» В ответ на эти претензии я отвечаю, что более половины наших клиентов оплачивают подписку повторно. А человек, недовольный сервисом, во второй раз платить не будет», — говорит Вадим.

Хороших результатов от использования сервиса добиваются не все подписчики Shikari. Этому есть несколько причин, одна из которых — специализация подписчика. Бывает, спрос на услуги какой-либо узкой сферы деятельности упал или в принципе не был высоким.
Но одна из ключевых причин неудач – неумение подписчиков обрабатывать заявки. По каждой из них нужно стучаться в личку к потенциальному заказчику, общаться с ним, предлагать ему свою услугу. При этом не стоит забывать о конкуренции со стороны других подписчиков Shikari, которые так же могут откликнуться на пост заказчика.
«Если человек в объявлении написал, что хочет получить какую-то услугу, а ты готов её оказать, это ещё не значит, что ты сможешь свою услугу ему продать. Потенциального заказчика нужно убедить, что именно ты достоин этой работы», — объясняет Вадим Шемаров.
Что дальше
Основное направление развития проекта на ближайшие месяцы – добавление новых категорий поиска. Это позволит привлечь к сервису представителей более широкого круга профессий и сфер деятельности. Существующие категории планируется сделать более удобными для пользователей. Для этого их будут сегментировать на узкие направления.
«Мы поняли, что направление поиска лидов по конкретным заданным категориям работает, и его можно ставить на поток. Это рыночный продукт, и мы на нём зарабатываем уже сейчас. Мы будем развивать его и дальше для того, чтобы пользователям было удобнее, лучше, эффективней и интересней», — делится планами Вадим Шемаров.
В последнее время к сервису проявляют интерес несколько крупных онлайн-сервисов. Им интересны технологии поиска и обработки лидов, которые использует Shikari. Планируется и сотрудничество с крупными компаниями в других сферах. Для них будет запущено отдельное направление, связанное с разработкой индивидуальных решений под конкретного клиента.
Источник: biz360.ru
ChatGPT: как и сколько можно заработать на искусственном интеллекте, лучшие ИИ нейронки
В последнее время примерно такие мысли в голове, ведь нейронная сеть сейчас, без приувелечений, ВЕЗДЕ. Каждый знает и слышал об этой теме в году 17-ом, когда, в основном блогеры, снимали смешнявые видеоролики с тупым ботом несущим бред. Но почему это снова хайпит и как нам на этом можно заработать/сэкономить?
93 просмотров
Cryptovestnik — обзоры нейронок, NFT и криптовалютных проектов.
Для начала.
Пройдёмся по нудному, но нужному. что это такое?:
AI (Искусственный интеллект) – свойство искусственных интеллектуальных систем выполнять творческие, и не очень, функции, которые в основном относятся к человеческой работе. Пытался максимально просто описать.
В 2022 году AI ворвался во все возможные сферы: маркетинг, фото, видео, аудио, и очень много т. п. То есть, уже прямо сейчас ты можешь с помощью нейронных сетей сделать своё фото, видео, или даже реферат в школу. Стоит лишь написать запрос, желательно много и довольно точно описывающие твои желания, и через минуты 3 смотришь результат работы.
На картинке сверху, нейронка изобразила: свинья, криптовалюта, биткоин, царь. Для более точного результата лучше вводить 20+ тегов и все на английском. Сейчас это выглядит более чем смешно, вместо копыт — пальцы, пятачок с узорами, и в общем, чё с ней?
Но сравнивая с результатами 2017 года, можно однозначно отметить то, что прогресс действительно незамедлительно растет. Если тогда это были чат боты, которые еле умели связать два слова адекватно, или месиво из набора цветов. То сейчас это и вправду достойные работы, ведь нейросети улучшаются с каждым новым запросом, накопительным эффектом, то есть, своими запросами — вы помогаете ей стать лучше и более точной. Фриланс художники даже устроили бунт, ведь работы, которые сгенерировала нейронная сеть, продавали как ручные. Нужно лишь здраво оценивать возможности AI на данный момент, но они уже, даже сейчас, впечатляют.
stability.ai — сервис для изучения «Как правильно написать запрос в нейронке»
Да что тут говорить, даже в TikTok одним из самых популярных трендов — это нейронка, генерирующая аниме версию фотографии. Глупо спорить что AI очередная, БЕСПОЛЕЗНАЯ, технология, ведь она помогает миллионам уже сейчас.
Как нам на этом заработать?
Конечно многие знают о нейронных сетях, но всё таки это остаётся больше уделом всяких гиков, и большая часть интернета не представляет всю мощь AI.А в свою очередь это намёк к формуле успеха:
Продавать «нейронный» труд
То есть, мы для начала выбираем спектр нашей деятельности (тексты, видео, аудио, фото и т.д.) и с помощью нейронки создаём своё собственное портфолио.Далее идём на фриланс биржи, красиво оформляем, и идём искать заказчиков.Может по началу мы будем работать почти за бесплатно, но это всё дело времени и правильного подхода, как себя преподнести. Одно из самых главных: чтобы заказчик не догадался, и даже не думал, о подвохе. Не кидайте работу сразу как она сгенерировалась, ждите, и прочие нюансы.
Виды заработка:
Один из самых простейших видов заработка на AI — это именно работа с текстом. Конечно нейронка еще не способна ПОЛНОСТЬЮ заменить копирайтеров, но уже идеально справляется с задачами среднего уровня, и даже чуть выше.
Для текстовых задач подойдут такие AI как: Jasper.Ai и Rytr. Они не очень сложны в освоении, нужно лишь посидеть и потыкать кнопки в целях ознакомления.
А так же есть ещё одна очень крутая нейронная сеть от OpenAI, под названием ChatGPT. Этот бот способен ответить практически на любой вопрос, сгенерировать текст, или даже написать РАБОЧИЙ код. Последние 2 пункта как раз нам и будут полезны. Для вашего представления, чтоб вы примерно поняли насколько этот бот передовой, он может написать целый, сформулированный, блог, который серьёзно будет интересно читать.
А монетизировать это мы можем с помощью создания своего собственного блога. Трафик идёт, люди кликают, вы зарабатываете, НО. это целая работа, и требуется определенное количество времени + заинтересованность, после автоматизации всего рабочего процесса, можно уверенно получать +500$ в месяц.
Или же брать текста на заказ и работать как фрилансер, но, как я писал выше, для доверия на фриланс биржах вы должны сделать портфолио и заработать отзывы.Да и что тут говорить, областей применения текстовых-AI безумно много, поможет только фантазия. Тем более ChatGPT бесплатный!
Тут уже всё немного сложнее, ведь в основном заказчики дают определённое ТЗ, какую работу требуется проделать если это арт-проект или же просто что-то концептуальное, и нейронка вряд ли разберётся как ей это сделать. Но обычную, достойную, обработку ей не составит труда сделать в один клик. И в основном за обработанную фотографию на Faverr берут около 10$.
Или же наоборот, создавать что-то своё, своё уникальный арт. С этим нам поможет сервис Dall-E 2 от того же OpenAI. Он создаёт уникальные арты непохожие друг на друга. То есть, авторские права будут у вас. Я уже писал как правильно «нарисовать» арт, так что не вижу причин ждать.
Да, монтаж видео это всё та же монотонная работа, так что AI вполне способен её заменить. Основываясь на скрипте или тексте нейронка подбирает видеоряд из стоковых видео. Нам прекрасно подойдёт сервис Pictory AI, он пока что справляется со своей работой лучше своих конкурентов. Но нейронные сети, созданные для помощи с видео, на мой взгляд, самые недоработанные, ведь там часто бывают баги. Не познакомить вас с ними было бы неправильно, но пока что работать с ними не очень советую.
Так как есть множество AI сервисов которые могут работать с видео, то конечно есть и куча сервисов для работы с аудио. Например: обработка из текста в аудио, из аудио в текст (например для субтитров). Нам смогут помочь эти сервисы: Murf.AI, Veed.io. Последний, по моему опыту, один из самых достойных и качественных аудио AI, в нём можно делать сразу две этих функции.
Конечно, технология супер интересная и она не обошла стороной криптовалюту. Уже начинают появляться некоторые проекты с использованием AI, и когда-то это точно станет трендом.
Что мы имеем после всего того, что мы узнали? Если собрать все пункты в один большой пункт, мы получаем набор для автоматизации тех же роликов на YouTube. Я сам знаю некоторых людей которые занимаются этим, и доход в месяц там измеряется в тысячах долларов. Но мы можем и заниматься чем-то определённым на фриланс биржах, тут только на ваше усмотрение.
Может показаться что это какой-то читинг или обман, но бро, мне кажется у тебя довольно старое мышление если ты так подумал, ведь AI именно и созданы для того чтобы облегчить всю твою работу. Надеюсь вы правильно используете информацию и сможете заработать!
Cryptovestnik — обзоры нейронок, NFT и криптовалютных проектов.
- https://www.veed.io/
- https://openai.com/dall-e-2/
- https://chat.openai.com/chat
- https://rytr.me/https://murf.ai/
- https://app.pictory.ai/
- https://hotpot.ai/
- https://www.autoenhance.ai/
- https://www.befunky.com/
- https://creator.nightcafe.studio/
Обязательно ставьте реакции и делитесь своим мнением на счёт Нейронных сетей! Всем до скорого!
Источник: vc.ru
Как работают нейронные сети и почему они стали приносить большие деньги
За последнее десятилетие компьютеры заметно улучшили свои возможности в области понимания окружающего мира. ПО для фототехники автоматически распознаёт лица людей. Смартфоны преобразуют речь в текст. Робомобили распознают объекты на дороге и избегают столкновения с ними.
В основе всех этих прорыWow лежит технология работы искусственного интеллекта (ИИ) под названием глубокое обучение (ГО). ГО основывается на нейросетях (НС), структурах данных, вдохновлённых сетями, составленными из биологических нейронов. НС организуются послойно, и входы одного слоя соединены с выходами соседнего.
Специалисты по информатике экспериментируют с НС с 1950-х годов. Однако основы сегодняшней обширной индустрии ГО заложили два крупных прорыва – один произошёл в 1986 году, второй – в 2012. Прорыв 2012 года – революция ГО – была связана с открытием того, что использование НС с большим количеством слоёв позволит нам значительно улучшить их эффективность. Открытию способстWowали растущие объёмы как данных, так и вычислительных мощностей.
В данной статье мы введём вас в мир НС. Мы объясним, что такое НС, как они работают и откуда взялись. И мы изучим, почему– несмотря на многие десятилетия предыдущих исследований – НС стали чем-то реально полезным только в 2012 году.
Нейросети появились ещё в 1950-х

Фрэнк Розенблатт работает над своим перцептроном – ранней моделью НС
Идея НС довольно старая – по крайней мере, по стандартам информатики. Ещё в 1957 году Фрэнк Розенблатт из Корнеллского университета опубликовал отчёт с описанием ранней концепции НС под названием перцептрон. В 1958 году при поддержке ВМФ США он создал примитивную систему, способную анализировать изображение 20х20 пикселей и распознавать простейшие геометрические фигуры.
Основной целью Розенблатта было не создание практической системы классификации изображений. Он пытался понять, как работает человеческий мозг, создавая вычислительные системы, организованные по его подобию. Однако эта концепция вызвала чрезмерный энтузиазм третьих лиц.
«Сегодня ВМФ США раскрыл миру зародыш электронного компьютера, который, как ожидается, сможет ходить, говорить, видеть, писать, воспроизводить себя и осознавать своё сущестWowание», — писали в The New York Times.
По сути, каждый нейрон в НС представляет собой просто математическую функцию. Каждый нейрон высчитывает взвешенную сумму входных данных – чем больше вес входа, тем сильнее эти входные данные влияют на выходные данные нейрона. Затем взвешенная сумма скармливается нелинейной функции «активации» – на этом шаге НС способны моделировать сложные нелинейные явления.
Способности ранних перцептронов, с которыми экспериментировал Розенблатт – и НС в общем – проистекают из их возможности «обучаться» на примерах. НС обучают через подстройку входных весов нейронов на основе результатов работы сети с входными данными, выбранными для примера. Если сеть правильно классифицирует изображение, веса, вносящие свой вклад в правильный ответ, увеличиваются, а другие уменьшаются. Если сеть ошибается, веса подстраиваются в другом направлении.
Такая процедура позволяла ранним НС «обучаться» способом, немного напоминающим поведение нервной системы человека. Шумиха вокруг этого подхода не умолкала в 1960-е. Однако затем влиятельная книга 1969 года за авторством специалистов по информатике Марвина Минского и Сеймура Паперта показала, что у этих ранних НС есть значительные ограничения.
У ранних НС Розенблатта было всего один-два обучаемых слоя. Минский и Паперт показали, что подобные НС математически неспособны моделировать сложные явления реального мира.
В принципе, более глубокие НС были более способными. Однако такие НС перенапрягли бы те жалкие вычислительные ресурсы, что были у компьютеров в те времена. Простейшие алгоритмы поиска восхождением к вершине, использовавшиеся в первых НС, не масштабировались для более глубоких НС.
В итоге НС растеряли всю поддержку в 1970-х и начале 1980-х – это была часть эры «зимы ИИ».
Прорывной алгоритм

Моя собственная нейросеть на основе «мягкого оборудования» считает, что вероятность присутствия на этой фотографии хот-дога равна 1. Мы разбогатеем!
Удача вновь повернулась лицом к НС благодаря знаменитой работе 1986 года, введшей в обиход концепцию обратного распространения – практический метод обучения НС.
Допустим, вы работаете программистом в воображаемой компании, производящей ПО, и вам дали поручение сделать приложение, определяющее, есть ли на изображении хот-дог. Вы начинаете работу со случайным образом инициализированной НС, принимающей на вход изображение, и выдающей на выход значение от 0 до 1 – где 1 означает «хот-дог», а 0 означает «не хот-дог».
Для обучения сети вы набираете тысячи изображений, под каждой из которых есть метка, обозначающая, есть ли на этом изображении хот-дог. Вы скармливаете ей первое изображение – и хот-дог на нём есть – в нейросеть. Она выдаёт выходное значение в 0,07, что означает «хот-дога нет». Это неправильный ответ; сеть должна была выдать ответ, близкий к 1.
Цель алгоритма обратного распространения – так подстроить входные веса, чтобы сеть выдавала более высокое значение в случае, если ей снова выдать это изображение – и, желательно, другие изображения, где есть хот-доги. Для этого алгоритм обратного распространения начинает с изучения входных нейронов слоя, являющегося выходным. У каждого значения есть переменная веса. Алгоритм обратного распространения подстраивает каждый вес в таком направлении, чтобы НС выдавала более высокое значение. Чем выше входное значение, тем больше увеличивается его вес.
Пока что я описываю простейший алгоритм восхождения к вершине, знакомый исследователям ещё в 1960-х. Прорыв обратного распространения стал следующим шагом: алгоритм использует частные производные для распределения «вины» за неверный выход среди входов нейронов. Алгоритм подсчитывает, как на окончательный выход нейрона будет влиять небольшое изменение каждого входного значения, и подвинет ли это изменение результат ближе к правильному ответу, или наоборот.
В итоге получается набор значений ошибок для каждого нейрона в предыдущем слое – по сути, сигнал, оценивающий, было ли значение каждого нейрона слишком большим или слишком малым. Затем алгоритм повторяет процесс подстройки для новых нейронов из второго [с конца] слоя. Он немного изменяет входные веса каждого нейрона, чтобы подтолкнуть сеть ближе к правильному ответу.
Затем алгоритм снова использует частные производные для расчёта того, как значение каждого входа предыдущего слоя повлияло на ошибки выхода этого слоя – и распространяет эти ошибки назад, на пред-предыдущий слой, где процесс снова повторяется.
Это просто упрощённая модель работы обратного распространения. Если вам нужны подробные математические детали, рекомендую книгу Майкла Нильсена по этой теме [и у нас есть её перевод / прим. перев.]. Для наших целей достаточно того, что обратное распространение радикально изменило диапазон обучаемых НС. Люди уже не были ограничены простыми сетями с одним-двумя слоями. Они могли создавать сети с пятью, десятью или пятидесятью слоями, и у этих сетей могла быть произвольно сложная внутренняя структура.
Изобретение обратного распространения запустило второй бум НС, начавший выдавать практические результаты. В 1998 году группа исследователей из AT&T показала, как можно использовать нейросети для распознавания рукописных цифр, что позволило автоматизировать обработку чеков.
«Основной посыл этой работы в том, что мы можем создавать улучшенные системы распознавания закономерностей, больше полагаясь на автоматическое обучение и меньше – на разработанную вручную эвристику», — писали авторы.
И всё же в этой фазе НС были лишь одной из многих технологий в распоряжении исследователей машинного обучения (МО). Когда я обучался на курсе ИИ в институте в 2008 году, нейросети были всего лишь одним из девяти алгоритмов МО, из которых мы могли выбирать вариант, подходящий для выполнения задания. Однако ГО уже готовилось затмить остальные технологии.
Большие данные демонстрируют всю мощь глубокого обучения

Обнаружено расслабление. Вероятность пляжа 1.0. Запускаем процедуру употребления Май Тай.
Обратное распространение облегчило процесс обсчёта НС, однако более глубоким сетям всё равно требовалось больше вычислительных ресурсов, чем мелким. Результаты исследований, проводимых в 1990-х и 2000-х годах часто показывали, что от дополнительного усложнения НС можно было получать всё меньше выгоды.
Затем мышление людей изменила знаменитая работа 2012 года, где описывалась НС под именем AlexNet, названная в честь ведущего исследователя Алекса Крижевского. Куда как более глубокие сети могли обеспечивать прорывную эффективность, но только в сочетании с изобилием компьютерных мощностей и огромным количеством данных.
AlexNet разработала троица специалистов по информатике из университета Торонто для участия в научном конкурсе ImageNet. Организаторы конкурса насобирали в интернете миллион изображений, каждое из которых было размечено и отнесено к одной из тысяч категорий объектов, например, «вишня», «контейнеровоз» или «леопард». Исследователям ИИ предлагалось обучить свои МО-программы на части из этих изображений, а потом попытаться проставить правильные метки для других изображений, с которыми ПО не встречалось до этого. ПО должно было выбрать пять возможных меток для каждой картинки, и попытка считалась удачной, если одна из них совпадала с реальной.
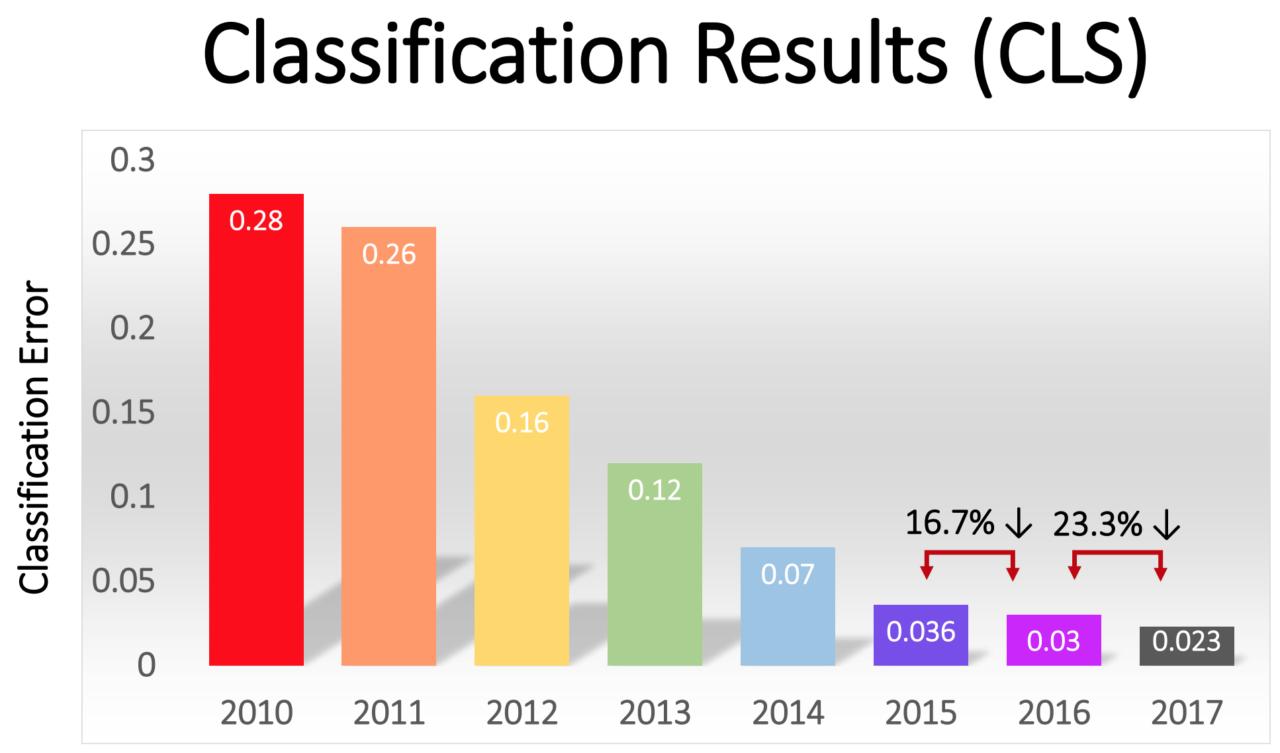
Это было сложной задачей, и до 2012 года результаты были не очень хорошими. У победителя 2011 года процент ошибок составлял 25%.
В 2012 году команда AlexNet обошла всех конкурентов на голову, выдав ответы с 15% ошибок. У ближайшего конкурента этот показатель равнялся 26%.
Исследователи из Торонто скомбинировали несколько техник для достижения прорывных результатов. Одной из них было использование свёрточных нейростей (СНС). По сути, СНС как бы обучает небольшие нейросети – входные данные которых представляют собой квадраты со стороной 7-11 пикселей – а потом «накладывают» их на более крупное изображение.
«Это похоже на то, как если бы вы взяли небольшой шаблон или трафарет, и пытались сравнить его с каждой точкой изображения, — рассказал нам в прошлом году исследователь ИИ Цзе Тан. – У вас есть трафарет собачки, и вы прикладываете его к изображению, и смотрите – есть ли там собачка? Если нет, сдвигаете трафарет. И так для всей картинки. И неважно, где на картинке появляется собачка.
Трафарет с ней совпадёт. Каждая подсекция сети не должна становиться отдельным классификатором собак».
Ещё одним ключевым фактором успеха AlexNet стало использование графических карт для ускорения процесса обучения. У графических карт есть параллельные вычислительные мощности, хорошо подходящие для повторяющихся вычислений, необходимых для обучения нейросети. Перенеся груз вычислений на пару GPU — Nvidia GTX 580, по 3 Гб памяти на каждой – исследователи смогли разработать и обучить чрезвычайно крупную и сложную сеть. У AlexNet было восемь обучаемых слоёв, 650 000 нейронов и 60 млн параметров.
Наконец, успех AlexNet обеспечил ещё и большой размер базы обучающих изображений из ImageNet: миллион штук. Нужно очень много изображений для точной подстройки 60 млн параметров. Достичь решительной победы AlexNet помогла комбинация из сложной сети и крупного набора данных.
Интересно, почему же подобный прорыв не произошёл ранее:
- Пара GPU потребительского качества, использованная исследователями AlexNet, была далеко не самым мощным вычислительным устройством для 2012 года. За пять и даже за десять лет до этого сущестWowали более мощные компьютеры. Кроме того, технология ускорения обучения НС при помощи графических карт была известна по крайней мере с 2004.
- База из миллиона изображений была необычно большой для обучения алгоритмов МО в 2012 году, однако сбор подобных данных не был новой технологией для того года. Исследовательская группа с хорошим финансированием смогла бы без особых проблем собрать базу данных такого размера ещё на пять или десять лет раньше.
- Основные алгоритмы, использовавшиеся в AlexNet, не были новыми. Алгоритм обратного распространения к 2012 году сущестWowал уже примерно четверть века. Ключевые идеи, связанные со свёрточными нейросетями были выработаны в 1980-х и 1990-х.
Увеличение глубины НС практически не улучшало эффективность их работы, если использовались недостаточно большие наборы обучающих данных. А расширение набора данных не улучшало эффективности небольших сетей. Чтобы увидеть прирост эффективности, нужны были как более глубокие сети, так и более крупные наборы данных – плюс значительные вычислительные мощности, позволяющие провести процесс обучения за разумное время. Команда AlexNet стала первой, собравшей все три элемента в одной программе.
Бум глубокого обучения

Демонстрацию всей мощи глубокой НС, обеспеченной достаточным количеством обучающих данных, заметило много людей – как среди учёных-исследователей, так и среди представителей индустрии.
Первым изменилось само состязание ImageNet. До 2012 года большая часть участников соревнования использовали технологии, отличные от глубокого обучения. В состязании 2013 года, как писали спонсоры, «большая часть» конкурсантов использовали ГО.
Процент ошибок у победителей постепенно снижался – от впечатляющих 16% у AlexNet в 2012 году до 2,3% в 2017 году:
Революция ГО быстро распространилась и по индустрии. В 2013 Google приобрёл стартап, сформированный из авторов работы AlexNet, и использовал его технологию в качестве базы для функции поиска изображений в сервисе Google Photos. К 2014 году Facebook расхваливала собственное ПО, распознающее изображения при помощи ГО. Apple использует ГО для распознавания лиц в iOS, по крайней мере, с 2016 года.
ГО также лежит в основе недавнего улучшения технологии распознавания голоса. Siri от Apple, Alexa от Amazon, Cortana от Microsoft и ассистент от Google используют ГО – либо для понимания слов человека, либо для генерации более естественного голоса, либо и для того, и для другого.
В последние годы в индустрии образовалась самоподдерживающаяся тенденция, в рамках которой увеличение вычислительных мощностей, объёмов данных и глубины сетей поддерживают друг друга. Команда AlexNet использовала GPU потому, что они предлагали параллельные вычисления за разумные деньги. Но за последние несколько лет всё больше компаний начали разрабатывать собственные чипы, специально предназначенные для применения в области МО.
Google объявила о выпуске специально предназначенного для НС чипа Tensor Processing Unit в 2016. В том же году Nvidia объявила о выходе нового GPU под названием Tesla P100, оптимизированного для НС. Intel ответила на вызов своим ИИ-чипом в 2017. В 2018 Amazon объявила о выпуске собственного ИИ-чипа, который можно будет использовать в рамках облачных сервисов компании. Даже Microsoft, как говорят, работает над своим ИИ-чипом.
Производители смартфонов также работают над чипами, которые позволят мобильным устройствам выполнять больше вычислений при помощи НС локально, без необходимости загружать данные на сервера. Подобные вычисления на устройства уменьшают задержки и усиливают конфиденциальность.
Даже Tesla вступила в эту игру со специальными чипами. В этом году Tesla показала новый мощный компьютер, оптимизированный для расчётов НС. Tesla назвала его Full Self-Driving Computer и представила, как ключевой момент стратегии компании по превращению парка Tesla в робомобили.
Доступность компьютерных мощностей, оптимизированных для ИИ, породила запрос на данные, необходимые для обучения всё более сложных НС. Эта динамика наиболее очевидна в секторе робомобилей, где компании собирают данные о миллионах километров реальных дорог. Tesla может собирать такие данные автоматически с автомобилей пользователей, а её конкуренты, Waymo и Cruise платили водителям, которые ездили на их автомобилях по общественным дорогам.
Запрос на данные даёт преимущество крупным онлайн-компаниям, у которых уже есть доступ к большим объёмам пользовательских данных.
Глубокое обучение покорило так много разных областей из-за своей чрезвычайной гибкости. Десятилетия проб и ошибок позволили исследователям выработать базовые кирпичики для выполнения наиболее распространённых задач в области МО – типа свёрточных сетей для эффективного распознавания изображений. Однако если у вас есть подходящая по схеме сеть высокого уровня и достаточно данных, то процесс её обучения будет несложным. Глубокие НС способны распознавать исключительно широкий диапазон сложных закономерностей без специального руководства со стороны людей-разработчиков.
Тому, конечно, есть ограничения. К примеру, некоторые люди баловались с идеей обучения робомобилей при помощи одного лишь ГО – то есть, скармливать изображения, получаемые с камеры, нейросети, и получать от неё инструкции по повороту руля и нажатию педалей. Я скептически отношусь к такому подходу.
НС пока ещё не продемонстрировали способности проводить сложные логические рассуждения, которые требуются для понимания определённых условий, возникающих на дороге. Более того, НС представляют собой «чёрные ящики», рабочий процесс которых практически невидим. Оценить и подтвердить безопасность такой системы было бы сложно.
Однако ГО позволило сделать весьма широкие скачки в неожиданно большом спектре приложений. В ближайшие годы можно ожидать очередных подвижек в этой области.
- глубокое обучение
- нейронные сети
- Машинное обучение
- История IT
- Искусственный интеллект
Источник: habr.com