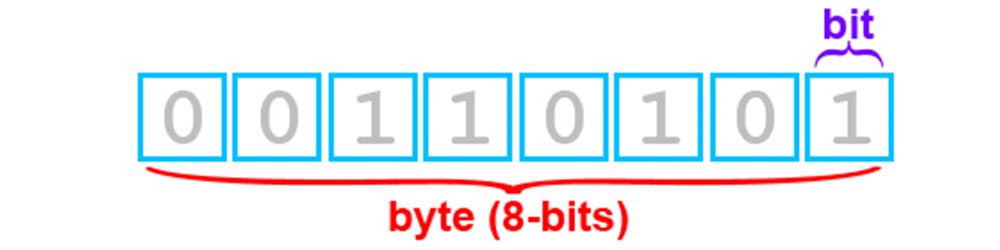
Каждый символ информационного сообщения несёт фиксированное количество информации.
Единицей измерения количества информации является бит – это наименьшаяединица.
1 Кб (килобайт) = 1024 байта= 2 10 байтов
1 Мб (мегабайт) = 1024 Кб = 2 10 Кб
1 Гб (гигабайт) = 1024 Мб = 2 10 Мб
1 Тб (терабайт) =1024 Гб = 2 10 Гб
Формулы, которые используются при решении типовых задач:
Информационный вес символа алфавита и мощность алфавита связаны между собой соотношением: N = 2 i .
Информационный объём сообщения определяется по формуле:
I – объём информации в сообщении;
К – количество символов в сообщении;
i – информационный вес одного символа.
Основная литература:
- Босова Л. Л. Информатика: 7 класс. // Босова Л. Л., Босова А. Ю. – М.: БИНОМ, 2017. – 226 с.
Дополнительная литература:
- Босова Л. Л. Информатика: 7–9 классы. Методическое пособие. // Босова Л. Л., Босова А. Ю., Анатольев А. В., Аквилянов Н.А. – М.: БИНОМ, 2019. – 512 с.
- Босова Л. Л. Информатика. Рабочая тетрадь для 7 класса. Ч 1. // Босова Л. Л., Босова А. Ю. – М.: БИНОМ, 2019. – 160 с.
- Босова Л. Л. Информатика. Рабочая тетрадь для 7 класса. Ч 2. // Босова Л. Л., Босова А. Ю. – М.: БИНОМ, 2019. – 160 с.
- Гейн А. Г. Информатика: 7 класс. // Гейн А. Г., Юнерман Н. А., Гейн А.А. – М.: Просвещение, 2012. – 198 с.
Теоретический материал для самостоятельного изучения.
Алфавитный подход к определению количества информации
Любое сообщение несёт некоторое количество информации. Как же его измерить?
Одним из способов измерения информации является алфавитный подход, который говорит о том, что каждый символ любого сообщения имеет определённый информационный вес, то есть несёт фиксированное количество информации.
Сегодня на уроке мы узнаем, чему равен информационный вес одного символа и научимся определять информационный объём сообщения.
Что же такое символ в компьютере? Символом в компьютере является любая буква, цифра, знак препинания, специальный символ и прочее, что можно ввести с помощью клавиатуры. Но компьютер не понимает человеческий язык, он каждый символ кодирует. Вся информация в компьютере представляется в виде нулей и единичек. И вот эти нули и единички называются битом.
Информационный вес символа двоичного алфавита принят за минимальную единицу измерения информации и называется один бит.
Алфавит любого понятного нам языка можно заменить двоичным алфавитом. При этом мощность исходного алфавита связана с разрядностью двоичного кода соотношением: N = 2 i .
Эту формулу можно применять для вычисления информационного веса одного символа любого произвольного алфавита.
Рассмотрим пример:
Алфавит древнего племени содержит 16 символов. Определите информационный вес одного символа этого алфавита.
Составим краткую запись условия задачи и решим её:
16 = 2 i , 2 4 = 2 i , т. е. i = 4
Ответ: i = 4 бита.
Информационный вес одного символа этого алфавита составляет 4 бита.
#2. Бит, байт и т.д. / 2. Информация и числа в компьютере / Программирование с нуля
Сообщение состоит из множества символов, каждый из которых имеет свой информационный вес. Поэтому, чтобы вычислить объём информации всего сообщения, нужно количество символов, имеющихся в сообщении, умножить на информационный вес одного символа.
Математически это произведение записывается так: I = К · i.
Например: сообщение, записанное буквами 32-символьного алфавита, содержит 180 символов. Какое количество информации оно несёт?
32 = 2 i , 2 5 = 2 i , т.о. i = 5,
I = 180 · 5 = 900 бит.
Ответ: I = 900 бит.
Итак, информационный вес всего сообщения равен 900 бит.
I = 23 · 8 = 184 бита.
Значит, сообщение весит 184 бита.
Как и в математике, в информатике тоже есть кратные единицы измерения информации. Так, величина равная восьми битам, называется байтом.
Бит и байт – это мелкие единицы измерения. На практике для измерения информационных объёмов используют более крупные единицы: килобайт, мегабайт, гигабайт и другие.
1 Кб (килобайт) = 1024 байта= 2 10 байтов
1 Мб (мегабайт) = 1024 Кб = 2 10 Кб
1 Гб (гигабайт) = 1024 Мб = 2 10 Мб
1 Тб (терабайт) =1024 Гб = 2 10 Гб
Итак, сегодня мы узнали, что собой представляет алфавитный подход к измерению информации, выяснили, в каких единицах измеряется информация и научились определять информационный вес одного символа и информационный объём сообщения.
Материал для углубленного изучения темы.
Как текстовая информация выглядит в памяти компьютера.
Набирая текст на клавиатуре, мы видим привычные для нас знаки (цифры, буквы и т.д.). В оперативную память компьютера они попадают только в виде двоичного кода. Двоичный код каждого символа, выглядит восьмизначным числом, например 00111111. Теперь возникает вопрос, какой именно восьмизначный двоичный код поставить в соответствие каждому символу?
Все символы компьютерного алфавита пронумерованы от 0 до 255. Каждому номеру соответствует восьмиразрядный двоичный код от 00000000 до 11111111. Этот код ‑ просто порядковый номер символа в двоичной системе счисления.
Таблица, в которой всем символам компьютерного алфавита поставлены в соответствие порядковые номера, называется таблицей кодировки.Таблица для кодировки – это «шпаргалка», в которой указаны символы алфавита в соответствии порядковому номеру. Для разных типов компьютеров используются различные таблицы кодировки.
Таблица ASCII (или Аски), стала международным стандартом для персональных компьютеров. Она имеет две части.

В этой таблице латинские буквы (прописные и строчные) располагаются в алфавитном порядке. Расположение цифр также упорядочено по возрастанию значений. Это правило соблюдается и в других таблицах кодировки и называется принципом последовательного кодирования алфавитов. Благодаря этому понятие «алфавитный порядок» сохраняется и в машинном представлении символьной информации. Для русского алфавита принцип последовательного кодирования соблюдается не всегда.
01100110 01101001 01101100 01100101.
А теперь попробуем решить обратную задачу. Какое слово записано следующим двоичным кодом:
01100100 01101001 01110011 01101011?
В таблице 2 приведен один из вариантов второй половины кодовой таблицы АSСII, который называется альтернативной кодировкой. Видно, что в ней для букв русского алфавита соблюдается принцип последовательного кодирования.

Вывод: все тексты вводятся в память компьютера с помощью клавиатуры. На клавишах написаны привычные для нас буквы, цифры, знаки препинания и другие символы. В оперативную память они попадают в форме двоичного кода.
Из памяти же компьютера текст может быть выведен на экран или на печать в символьной форме.
Сейчас используют целых пять систем кодировок русского алфавита (КОИ8-Р, Windows, MS-DOS, Macintosh и ISO). Из-за количества систем кодировок и отсутствия одного стандарта, очень часто возникают недоразумения с переносом русского текста в компьютерный его вид. Поэтому, всегда нужно уточнять, какая система кодирования установлена на компьютере.
Разбор решения заданий тренировочного модуля
№1. Определите информационный вес символа в сообщении, если мощность алфавита равна 32?
Информационный вес символа алфавита и мощность алфавита связаны между собой соотношением: N = 2 i .
32 = 2 i , 32 – это 2 5 , следовательно, i =5 битов.
Ответ: 5 битов.
№2. Выразите в килобайтах 2 16 байтов.
2 16 можно представить как 2 6 · 2 10 .
2 6 = 64, а 2 10 байт – это 1 Кб. Значит, 64 · 1 = 64 Кб.
Ответ: 64 Кб.
№3. Тип задания: выделение цветом
8 х = 32 Кб, найдите х.
8 можно представить как 2 3 . А 32 Кб переведём в биты.
Получаем 2 3х =32 · 1024 ·8.
Или 2 3х = 2 5 · 2 10 · 2 3 .
3х = 18, значит, х=6.
Набор символов знаковой системы (алфавит) можно рассматривать как различные возможные состояния (события).
Тогда, если считать, что появление символов в сообщении равновероятно, количество возможных событийN можно вычислить как N=2 i
Количество информации в сообщении I можно подсчитать умножив количество символов K на информационный вес одного символа i
Итак, мы имеем формулы, необходимые для определения количества информации в алфавитном подходе:
Если к этим задачам добавить задачи на соотношение величин, записанных в разных единицах измерения, с использованием представления величин в виде степеней двойки мы получим 9 типов задач.
Рассмотрим задачи на все типы. Договоримся, что при переходе от одних единиц измерения информации к другим будем строить цепочку значений. Тогда уменьшается вероятность вычислительной ошибки.
Задача 1. Получено сообщение, информационный объем которого равен 32 битам. чему равен этот объем в байтах?
Решение: В одном байте 8 бит. 32_8=4
Ответ: 4 байта.
Задача 2. Объем информацинного сообщения 12582912 битов выразить в килобайтах и мегабайтах.
Решение: Поскольку 1Кбайт=1024 байт=1024*8 бит, то 12582912:(1024*8)=1536 Кбайт и
поскольку 1Мбайт=1024 Кбайт, то 1536_1024=1,5 Мбайт
Ответ:1536Кбайт и 1,5Мбайт.
Задача 3. Компьютер имеет оперативную память 512 Мб. Количество соответствующих этой величине бит больше:
1) 10 000 000 000бит 2) 8 000 000 000бит 3) 6 000 000 000бит 4) 4 000 000 000бит Решение: 512*1024*1024*8 бит=4294967296 бит.
Ответ: 4.
Задача 4. Определить количество битов в двух мегабайтах, используя для чисел только степени 2.
Решение: Поскольку 1байт=8битам=2 3 битам, а 1Мбайт=2 10 Кбайт=2 20 байт=2 23 бит. Отсюда, 2Мбайт=2 24 бит.
Ответ: 2 24 бит.
Задача 5. Сколько мегабайт информации содержит сообщение объемом 2 23 бит?
Решение: Поскольку 1байт=8битам=2 3 битам, то
2 23 бит=2 23 *2 23 *2 3 бит=2 10 2 10 байт=2 10 Кбайт=1Мбайт.
Ответ: 1Мбайт
Задача 6. Один символ алфавита «весит» 4 бита. Сколько символов в этом алфавите?
Решение:
Дано:
| i=4 | По формуле N=2 i находим N=2 4 , N=16 |
| Найти: N — ? |
Задача 7. Каждый символ алфавита записан с помощью 8 цифр двоичного кода. Сколько символов в этом алфавите?
Решение:
Дано:
| i=8 | По формуле N=2 i находим N=2 8 , N=256 |
| Найти:N — ? |
Задача 8. Алфавит русского языка иногда оценивают в 32 буквы. Каков информационный вес одной буквы такого сокращенного русского алфавита?
Решение:
Дано:
| N=32 | По формуле N=2 i находим 32=2 i , 2 5 =2 i ,i=5 |
| Найти: i— ? |
Задача 9. Алфавит состоит из 100 символов. Какое количество информации несет один символ этого алфавита?
Решение:
Дано:
| N=100 | По формуле N=2 i находим 32=2 i , 2 5 =2 i ,i=5 |
| Найти: i— ? |
Задача 10. У племени «чичевоков» в алфавите 24 буквы и 8 цифр. Знаков препинания и арифметических знаков нет. Какое минимальное количество двоичных разрядов им необходимо для кодирования всех символов? Учтите, что слова надо отделять друг от друга!
Решение:
Дано:
| N=24+8=32 | По формуле N=2 i находим 32=2 i , 2 5 =2 i ,i=5 |
| Найти: i— ? |
Задача 11. Книга, набранная с помощью компьютера, содержит 150 страниц. На каждой странице — 40 строк, в каждой строке — 60 символов. Каков объем информации в книге? Ответ дайте в килобайтах и мегабайтах
Решение:
Дано:
| K=360000 | Определим количество символов в книге 150*40*60=360000. Один символ занимает один байт. По формуле I=K*iнаходим I=360000байт 360000_1024=351Кбайт=0,4Мбайт |
| Найти: I— ? |
Ответ: 351Кбайт или 0,4Мбайт
Задача 12. Информационный объем текста книги, набранной на компьютере с использованием кодировки Unicode, — 128 килобайт. Определить количество символов в тексте книги.
Решение:
Дано:
| I=128Кбайт,i=2байт | В кодировке Unicode один символ занимает 2 байта. Из формулыI=K*i выразимK=I/i,K=128*1024:2=65536 |
| Найти: K— ? |
Задача 13.Информационное сообщение объемом 1,5 Кб содержит 3072 символа. Определить информационный вес одного символа использованного алфавита
Решение:
Дано:
| I=1,5Кбайт,K=3072 | Из формулы I=K*i выразимi=I/K,i=1,5*1024*8:3072=4 |
| Найти: i— ? |
Задача 14.Сообщение, записанное буквами из 64-символьного алфавита, содержит 20 символов. Какой объем информации оно несет?
Решение:
Дано:
| N=64, K=20 | По формуле N=2 i находим 64=2 i , 2 6 =2 i ,i=6. По формуле I=K*i I=20*6=120 |
| Найти: I— ? |
Задача 15. Сколько символов содержит сообщение, записанное с помощью 16-символьного алфавита, если его объем составил 1/16 часть мегабайта?
Решение:
Дано:
| N=16, I=1/16 Мбайт | По формуле N=2 i находим 16=2 i , 2 4 =2 i ,i=4. Из формулы I=K*i выразим K=I/i, K=(1/16)*1024*1024*8/4=131072 |
| Найти: K— ? |
Задача 16. Объем сообщения, содержащего 2048 символов,составил 1/512 часть мегабайта. Каков размер алфавита, с помощью которого записано сообщение?
Решение:
Дано:
| K=2048,I=1/512 Мбайт | Из формулы I=K*i выразим i=I/K, i=(1/512)*1024*1024*8/2048=8. По формулеN=2 i находим N=2 8 =256 |
| Найти: N— ? |
Задачи для самостоятельного решения:
- Каждый символ алфавита записывается с помощью 4 цифр двоичного кода. Сколько символов в этом алфавите?
- Алфавит для записи сообщений состоит из 32 символов, каков информационный вес одного символа? Не забудьте указать единицу измерения.
- Информационный объем текста, набранного на компьюте¬ре с использованием кодировки Unicode (каждый символ кодируется 16 битами), — 4 Кб. Определить количество символов в тексте.
- Объем информационного сообщения составляет 8192 бита. Выразить его в килобайтах.
- Сколько бит информации содержит сообщение объемом 4 Мб? Ответ дать в степенях 2.
- Сообщение, записанное буквами из 256-символьного ал¬фавита, содержит 256 символов. Какой объем информации оно несет в килобайтах?
- Сколько существует различных звуковых сигналов, состоящих из последовательностей коротких и длинных звонков. Длина каждого сигнала — 6 звонков.
- Метеорологическая станция ведет наблюдение за влажностью воздуха. Результатом одного измерения является целое число от 20 до 100%, которое записывается при помощи минимально возможного количества бит. Станция сделала 80 измерений. Определите информационный объем результатом наблюдений.
- Скорость передачи данных через ADSL-соединение равна 512000 бит/с. Через данное соединение передают файл размером 1500 Кб. Определите время передачи файла в секундах.
- Определите скорость работы модема, если за 256 с он может передать растровое изображение размером 640х480 пикселей. На каждый пиксель приходится 3 байта. А если в палитре 16 миллионов цветов?
Тема определения количества информации на основе алфавитного подхода используется в заданиях А1, А2, А3, А13, В5 контрольно-измерительных материалов ЕГЭ.
1. Информационный объём текстового
сообщения
Расчёт
информационного объёма текстового сообщения (количества информации,
содержащейся в информационном сообщении) основан на подсчёте количества
символов в этом сообщении, включая пробелы, и на определении
информационного веса одного символа, который зависит от кодировки, используемой
при передаче и хранении данного сообщения.
Для расчёта
информационного объёма текстового сообщения используется формула
I = K * i , где
I – это информационный объём текстового сообщения,
измеряющийся в байтах, килобайтах, мегабайтах;
K – количество символов в
сообщении,
i – информационный вес одного символа, который
измеряется в битах на один символ.
Информационный
объём одного символа связан с количеством символов в алфавите формулой
N =2 i , где
N — это количество символов в алфавите (мощность
алфавита),
i — информационный
вес одного символа в битах на один символ.
2. Информационный объём растрового
графического изображения
Расчёт
информационного объёма растрового графического изображения (количества
информации, содержащейся в графическом изображении) основан на подсчёте количества
пикселей в этом изображении и на определении глубины
цвета (информационного веса одного пикселя).
Для расчёта
информационного объёма растрового графического изображения используется
формула
I = K * i , где
I – это информационный объём растрового графического
изображения, измеряющийся в байтах, килобайтах, мегабайтах;
K – количество пикселей (точек) в
изображении, определяющееся разрешающей способностью носителя информации
(экрана монитора, сканера, принтера);
i – глубина цвета, которая
измеряется в битах на один пиксель.
Глубина цвета связана с
количеством отображаемых цветов формулой
N =2 i , где
N – это количество цветов в палитре,
i – глубина цвета в битах на
один пиксель.
Каждый объект в компьютере (или любом другом электронном устройстве) имеет свой информационный объём, то есть то количество информации, которое он занимает в памяти устройства.
Например, текстовый документ на (2)–(3) страницы может иметь информационный объём (150) Кб.
Изображение в хорошем качестве — (2)–(4) Мб.
Аудиофайл с песней на (3) минуты — около (6) Мб.
Рассмотрим измерение текстовой информации в компьютере.
Размер текстового сообщения зависит от того, с помощью какого алфавита он был написан и сколько в нём символов.
Алфавит (N) — это количество символов в некотором языке.
Чем больше алфавит, тем больше информационный вес одного символа.
Информационный вес одного символа (i) — это количество информации, которое отводится на один символ.
Они связаны формулой:
Например, в русском алфавите (33) буквы, вычислим информационный вес одного символа по формуле:
бит. То есть вес одного символа (буквы) — (5) бит.
Представим, что в тетрадке записана следующая строка: «Мама сидела за столом».
Как посчитать, сколько информации несёт в себе это сообщение?
Нам известно, сколько весит один символ — (5) бит, можно подсчитать количество символов в данном сообщении — (18), соответственно, чтобы найти, сколько всего информации несёт в себе это сообщение, нужно перемножить информационный вес одного символа и количество символов в сообщении.
Можно вывести формулу:
где (I) — информационный объём сообщения;
(K) — количество символов в сообщении;
(i) — информационный вес одного символа.
Но мы будем работать с компьютерным текстом. Там алфавит намного больше.
Как ты думаешь, сколько всего символов можно ввести с клавиатуры?
Ты скажешь «много» и будешь прав: с клавиатуры можно ввести русские/английские буквы, цифры, специальные знаки и т. д. Всего (256) символов.
Посчитаем информационный вес одного символа компьютерного алфавита.
Один символ компьютерного алфавита весит (8) бит или (1) байт.
Найди информационный объём текста (в битах), написанного с помощью компьютера:
«Информация — это сведения об окружающем нас мире».
Текст напечатан на компьютере, поэтому один символ весит (8) бит или (1) байт.
Всего символов в сообщении между кавычками: (48). При подсчёте символов учитываются все символы и пробелы.
Задача
Найди информационный объём сообщения (в байтах), который напечатали школьники на уроке информатики, если оно содержит (2) страницы, на каждой странице по (12) строк, и в каждой строке (28) символов.
Оформим решение задачи.
Дано:
Чтобы посчитать, сколько символов всего в сообщении, нужно умножить количество страниц на количество строк и на количество символов в каждой строке.
В условии сказано, что текст напечатали, поэтому один символ равен (1) байту.
Р
ЕШЕНИЕ ЗАДАЧ
ПО ТЕМЕ «ИЗМЕРЕНИЕ ИНФОРМАЦИИ»
1 Кб = 1024 байта
Пример: перевести 2 Мб в Кб, байты, биты.
2 Мб = 2 · 1024 Кб = 2048 Кб
2 Мб = 2 · 1024 Кб · 1024 байт = 2097152 байт
2 Мб = 2 · 1024 Кб · 1024 байт · 8 бит = 16777216 бит
2 Мб = 2 · 1024 Кб = 2048 Кб
2048 Кб · 1024 байт = 2097152 байт
2097152 байт · 8 бит = 16777216 бит
Формула, связывающая между собой информационный вес каждого символа, выраженный в битах (i), и мощность алфавита (N):
N=2 i
Символом является и знак препинания, и цифра, и специальные знаки (в том числе и пробел)
Формула вычисления объема сообщения/объема информации (V):
V= K ·i
где K – количество символов
i — вес каждого символа, выраженный в битах
По умолчанию (если в задаче не указано специально) при решении задачи указывается 256-символьный алфавит – таблица ASCII (мощность алфавита = 256 символов). Значит, на один символ (букву, цифру, знак, знак препинания, пробел) приходится 8 бит информации или 1 байт.
Определить количество информации, которое содержится на печатном листе бумаги (двусторонняя печать), если на одной стороне умещается 40 строк по 67 символов в строке.
Определим количество символов на одной стороне листа:
40 строк · 67 символов = 2680 символов
Определим количество символов на 2-х сторонах листа:
2680 символов · 2 = 5360 символов
Количество информации = 5360 символов · 1 байт = 5360 байт
Переводим в Кб: 5360 байт : 1024 байт = 5,23 Кб
Если бы необходимо было получить ответ в бит, то
Количество информации = 5360 символов · 8 бит = 42880 бит
Переводим в байты 42880 бит : 8 бит = 5360 байт
Переводим в Кб 5360 байт : 1024 байт = 5,23 Кб
Какое количество информации будет содержаться на странице печатного текста при использовании 32-х символьного алфавита (на странице 60 строк по 56 символов).
Количество символов на странице = 60 строк · 56 символов = 3360 символов
По условию используется 32-х символьный алфавит
(т. е. мощность алфавита = 32 символа).
Тогда 2 i =32 символа, отсюда i = 5 бит.
Такое количество информации приходится на 1 символ 32-х символьного алфавита.
Количество информации, содержащееся на странице = 3360 символов · 5 бит = 16800 бит
Переводим в байты: 16800 бит : 8 бит = 2100 байт
Переводим в Кб 2100 байт : 1024 байт = 2,05 Кб
Алфавит содержит 32 буквы.
Какое количество информации несет одна буква?
Мощность алфавита N = 32
Какое количество информации несет одна буква?
2. i=5 значит вес одного символа 5 бит
Ответ: одна буква несет 5 бит информации.
Сообщение, записанное буквами из 16 символьного алфавита, содержит 10 символов. Какой объем информации в битах оно несет?
Мощность алфавита N = 16
текст состоит из 10 символов, K = 10
Определить объем информации в битах.
1. 16 = 2 4 , i = 4 значит вес одного символа 4 бита.
2. Всего символов 10, значит объем информации V= K ·i = 10 · 4 = 40 бит
Ответ: сообщение несет 40 бит информации
Информационное сообщение объемом 300 бит содержит 100 символов. Какова мощность алфавита?
Объем сообщения V = 300 бит
текст состоит из 100 символов, К = 100
Какова мощность алфавита?
1. Определим вес одного символа: i= V/К = 300 / 100 = 3 бита
2. Мощность алфавита N=2 i : 2 3 = 8.
Ответ: мощность алфавита N = 8.
Задания для самостоятельной работы:
1. Сколько бит в 2 байтах?
1. Сколько бит в 5 байтах?
2. Переведите 12 Кбайт в байты
2. Переведите 8 Кбайт в байты
3. Переведите 0,7 Мбайт в гигабайты
3. Переведите 0,5 Мбайт в гигабайты
4. 1 Кбайт = ___ байт = ______бит
4. 2 Кбайт = ___ байт = ______бит
5. Сколько Мбайт в 4 Гбайт?
5. Сколько Мбайт в 2 Гбайт?
6. Какое количество информации несет сообщение: «Встреча назначена на май»
6. Какое количество информации несет сообщение: «Да будет свет!»
7. Сколько бит содержится в слове ИНФОРМАЦИЯ?
7. Сколько бит содержится в слове КОМПЬЮТЕР?
Дискета имеет объем 1,44 Мбайт. Сколько дискет нужно, чтобы записать игру, содержащую 90 Мбайт?
Объем сообщения, содержащего 20 символов, составил 100 бит.
Определить размер алфавита, с помощью которого записано сообщение?
Сколько символов содержит сообщение, записанное с помощью 8 символьного алфавита, если объем его составил 120 бит?
Сколько символов в тексте, если мощность алфавита 64 символа, а объем информации, содержащейся в нем, — 1,5 килобайта?
В книге 100 страниц. На каждой странице 60 строк по 80 символов в строке.
Вычислить информационный объем книги.
Сообщение, записанное буквами из 8 символьного алфавита, содержит 20 символов.
Какой объем информации в битах оно несет?
Подсчитать в килобайтах количество информации в тексте, если текст состоит из 800 символов, а мощность используемого алфавита – 128 символов.
Подсчитать в килобайтах количество информации в тексте, если текст состоит из 800 символов, а мощность используемого алфавита – 256 символов.
Имеется два текста на разных языках. Первый текст использует 32-символьный алфавит и содержит 200 символов,
второй — 16-символьный алфавит и содержит 250 символов.
Какой из текстов содержит большее количество информации и на сколько битов?
Имеется два текста на разных языках. Первый текст использует 16-символьный алфавит и содержит 250 символов,
второй — 8-символьный алфавит и содержит 150 символов.
Какой из текстов содержит большее количество информации и на сколько битов?
Автор-разработчик: Киборт А.Н. преподаватель кафедры ООД
Источник: poiske.ru
Двоичная система счисления. Бит и байт. Сегментация памяти.
Вообще, как компьютер может хранить, например, слово «диск»? Главный принцип — намагничивание и размагничивание одной дорожки (назовем ее так). Одна микросхема памяти — это, грубо говоря, огромное количество дорожек. Сейчас попробуем разобраться. Например:
нуль будет обозначаться как 0000 (четыре нуля),
один 0001, два 0010,
(т.е. правую единицу заменяем на 0 и вторую устанавливаем в 1).
три 0011 четыре 0100 пять 0101 шесть 0110 семь 0111 восемь 1000 девять 1001
Уловили принцип? «0» и «1» — это т.н. биты. Один бит, как вы уже заметили, может быть нулем или единицей, т.е. размагничена или намагничена та или иная дорожка («0» и «1» это условное обозначение).
Если еще присмотреться, то можно заметить, что каждый следующий установленный бит (начиная справа) увеличивает число в два раза: 0001 в нашем примере = 1; 0010 два; 0100 четыре; 1000 восемь и т.д. Это и есть т.н. двоичная форма представления данных.
Т.о. чтобы обозначить числа от 0 до 9 нам нужно четыре бита (хоть они и не до конца использованы. Можно было бы продолжить: десять 1010, одиннадцать 1011 , пятнадцать 1111).
Компьютер хранит данные в памяти именно так. Для обозначения какого-нибудь символа (цифры, буквы, запятой, точки. ) в компьютере используется определенное количество бит. Компьютер «распознает» 256 (от 0 до 255) различных символов по их коду. Этого достаточно, чтобы вместить все цифры (0 — 9), буквы латинского алфавита (a — z, A — Z), русского (а — я, А — Я), а также другие символы.
Для представления символа с максимально возможным кодом (255) нужно 8 бит. Эти 8 бит называются байтом. Т.о. один любой символ — это всегда 1 байт (см. рис. 1).
| 0 | 1 | 0 | 1 | 1 | 0 | 1 | 0 |
| р | н | р | н | н | р | н | р |
Рис. 1. Один байт с кодом буквы Z
(буквы н и р обозначают: намагничено или размагничено соответственно)
Можно элементарно проверить. Создайте в текстовом редакторе файл с любым именем и запишите в нем один символ, например, «М» (но не нажимайте Enter!). Если вы посмотрите его размер, то файл будет равен 1 байту. Если ваш редактор позволяет смотреть файлы в шестнадцатеричном формате, то вы сможете узнать и код сохраненного вами символа. В данном случае буква «М» имеет код 4Dh в шестнадцатеричной системе, которую мы уже знаем или 1001101 в двоичной.
Т.о. слово «диск» будет занимать 4 байта или 4*8 = 32 бита. Как вы уже поняли, компьютер хранит в памяти не сами буквы этого слова, а последовательность «единичек» и «ноликов». «Почему же тогда на экране мы видим текст, а не «единички-нолики»? — спросите вы. Чтобы удовлетворить ваше любопытство, я забегу немного вперед и скажу, что всю работу по выводу самого символа на экран (а не битов) выполняет видеокарта (видеоадаптер), которая находится в вашем компьютере. И если бы ее не было, то мы, естественно, ничего бы не видели, что у нас творится на экране.
В Ассемблере после двоичного числа всегда должна стоять буква «b». Это нужно для того, чтобы при ассемблировании нашей программы Ассемблер смог отличать десятичные, шестнадцатеричные и двоичные числа. Например: 10 — это «десять», 10h — это «шестнадцать» а 10b — это «два» в десятичной системе.
Т.о. в регистры можно загружать двоичные, десятичные и шестнадцатеричные числа.
mov ax,20 mov bh,10100b mov cl,14h
В результате в регистрах AX, BH и CL будет находится одно и тоже число, только загружаем мы его в разных системах. Компьютер же будет хранить его в двоичном формате (как в регистре BH).
Итак, подведем итог. В компьютере вся информация хранится в двоичном формате (двоичной системе) примерно в таком виде: 10101110 10010010 01111010 11100101 (естественно, без пробелов. Для удобства я разделили биты по группам). Восемь бит — это один байт. Один символ занимает один байт, т.е. восемь бит. По-моему, ничего сложного.
Очень важно уяснить данную тему, так как мы будем постоянно пользоваться двоичной системой, и вам необходимо знать ее на «отлично».
Как перевести двоичное число в десятичное:
Надо сложить двойки в степенях, соответствующих позициям, где в двоичном стоят единицы. Например:
Возьмем число 20. В двоичной системе оно имеет следующий вид: 10100b
Итак (начнем слева направо, считая от 4 до 0; число в нулевой степени всегда равно единице (вспоминаем школьную программу по математике)):
10100b = 1*24 + 0*23 + 1*22 + 0*21 + 0*20 = 20 ——————————————— 16+0+4+0+0 = 20
Как перевести десятичное число в двоичное:
Можно делить его на два, записывая остаток справа налево:
20/2 = 10, остаток 0 10/2=5, остаток 0 5/2=2, остаток 1 2/2=1, остаток 0 1/2=0, остаток 1
В результате получаем: 10100b = 20
Как перевести шестнадцатеричное число в десятичное:
В шестнадцатеричной системе номер позиции цифры в числе соответствует степени, в которую надо возвести число 16:
8Ah = 8*16 + 10 (0Ah) = 138
В настоящий момент есть множество калькуляторов, которые могут считать и переводить числа в разных системах счисления. Например, калькулятор Windows, который должен быть в инженерном виде. Очень удобен калькулятор и в DOS Navigator’е. Если у вас есть он, то отпадает необходимость в ручном переводе одной системы в другую, что, естественно, упростит вам работу.
Однако, знать этот принцип крайне важно!
Сегментация памяти в DOS.
Возьмем следующее предложение: «Изучаем сегменты памяти». Теперь давайте посчитаем, на каком месте стоит буква «ы» в слове «сегменты» от начала предложения включая пробелы. На шестнадцатом. Подчеркну, что мы считали слово от начала предложения.
Теперь немного усложним задачу и разобьем предложение следующим образом (символом «_» обозначен пробел):
Пример N 1: 0000: Изучаем_ 0010: сегменты_ 0020: памяти 0030:
В слове «Изучаем» символ «И» стоит на нулевом месте; символ «з» на первом, «у» на втором и т.д. В данном случае мы считаем буквы начиная с нулевой позиции, используя два числа. Назовем их сегмент и смещение. Тогда, символ «ч» будет иметь следующий адрес: 0000:0003, т.е. сегмент 0000, смещение 0003.
Проверьте.
В слове «сегменты» будем считать буквы начиная с десятой позиции, но с нулевого смещения. Тогда символ «н» будет иметь следующий адрес: 0010:0005, т.е. пятый символ начиная с десятой позиции. 0010 — сегмент, 0005 смещение. Тоже проверьте.
В слове «память» считаем буквы начиная с 0020 сегмента и также с нулевой позиции. Т.о. символ «а» будет иметь аодрес 0020:0001, т.е. сегмент 0020, смещение 0001. Опять проверим.
Итак, мы выяснили, что для того, чтобы найти адрес нужного символа необходимо два числа: сегмент и смещение внутри этого сегмента. В Ассемблере сегменты хранятся в сегментных регистрах: CS, DS, ES, SS (см. предыдущий выпуск ), а смещения могут храниться в других (но не во всех).
Регистр CS служит для хранения сегмента кода программы (Code Segment — сегмент кода);
Регистр DS для хранения сегмента данных (Data Segment — сегмент данных);
Регистр SS для хранения сегмента стека (Stack Segment — сегмент стека);
Регистр ES дополнительный сегментный регистр, который может хранить любой другой сегмент (например, сегмент видеобуфера).
Пример N 2:
Давайте попробуем загрузить в пару регистров ES:DI сегмент и смещение буквы «м» в слове «памяти» из примера N 1 (см. выше). Вот как это запишется на Ассемблере:
(1) mov ax,0020 (2) mov es,ax (3) mov di,2
Теперь в регистре ES находится сегмент с номером 20, а регистре DI смещение к букве «м» в слове «памяти». Проверьте, пожалуйста.
Здесь стоит отметить, что загрузка числа (т.е. какого-нибудь сегмента) напрямую в сегментый регистр запрещена. Поэтому мы в строке (1) загрузили сегмент в AX, а в строке (2) загрузили в регистр ES число 20, которое находилось в регистре AX:
mov ds,15 —> ошибка! mov ss,34h —> ошибка!
Когда мы загружаем программу в память, она автоматически располагается в первом свободном сегменте. В файлах типа *.com все сегментные регистры автоматически инициализируются для этого сегмента (устанавливаются значения равные тому сегменту, в который загружена программа). Это можно проверить при помощи отладчика. Если, например, мы загружаем программу типа *.com в память, и компьютер находит первый свободный сегмент с номером 5674h, то сегментные регистры будут иметь следующие значения:
CS = 5674h DS = 5674h SS = 5674h ES = 5674h
Код программы типа *.com должны начинаться со смещения 100h. Для этого мы, собственно, и ставили в наших прошлых примерах программ оператор org 100h, указывая Ассемблеру при ассемблировании использовать смещение 100h от начала сегмента, в который загружена наша программа (позже мы рассмотрим для чего это нужно). Сегментные же регистры, как я уже говорил, автоматически принимают значение того сегмента, в который загрузилась наша программа.
Пара регистров CS:IP задает текущий адрес кода. Теперь рассмотрим, как все это происходит на конкретном примере:
Пример N 3.
(1) CSEG segment (2) org 100h (3) _start: (4) mov ah,9 (5) mov dx,offset My_name (6) int 21h (7) int 20h (8) My_name db ‘Oleg$’ (9) CSEG ends (10) end _start
Итак, строки (1) и (8) описывают сегмент: CSEG (даем имя сегменту) segment (оператор Ассемблера, указывающий, что имя CSEG — это название сегмента); CSEG ends (end segment — конец сегмента) указывает Ассемблеру на конец сегмента.
Строка (2) сообщает, что код программы (как и смещения внутри сегмента CSEG) необходимо отсчитывать с 100h. По этому адресу в память всегда загружаются программы типа *.com.
Запускаем программу из Примера N 3 в отладчике. Допустим, она загрузилась в свободный сегмент 1234h. Первая команда в строке (4) будет располагаться по такому адресу:
1234h:0100h (т.е. CS = 1234h, а IP = 0100h) (посмотрите в отладчике на регистры CS и IP).
Перейдем к следующей команде (в отладчике CodeView нажмите клавишу F8, в другом посмотрите какая клавиша нужна; будет написано что-то вроде «F8-Step»). Теперь вы видите, что изменились следующие регистры:
AX = 0900h (точнее, AH = 09h, а AL = 0, т.к. мы загрузили командой mov ah,9 число 9 в регистр AH, при этом не трогая AL. Если бы AL был равен, скажем, 15h, то после выполнения данной команды AX бы равнялся 0915h)
IP = 102h (т.е. указывает на адрес следующей команды. Из этого можно сделать вывод, что команда mov ah,9 занимает 2 байта: 102h — 100h = 2).
Следующая команда (нажимаем клавишу F8) изменяет регистры DX и IP. Теперь DX указывает на смещение нашей строки («Oleg$») относительно начала сегмента, т.е. 109h, а IP равняется 105h, т.е. адрес следующей команды. Нетрудно посчитать, что команда mov dx,offset My_name занимает 3 байта (105h — 102h = 3).
Обратите внимание, что в Ассемблере мы пишем:
mov dx,offset My_name
а в отладчике видим следующее:
mov dx,109 (109 — шестнадцатеричное число, но CodeView символ ‘h’ не ставит. Это надо иметь в виду).
Почему так происходит? Дело в том, что при ассемблировании программы, Ассемблер подставляет вместо offset My_name реальный адрес строки с именем My_name в памяти. Можно, конечно, записать сразу
mov dx,109h
Программа будет работать нормально. Но для этого нам нужно высчитать самим этот адрес. Попробуйте вставить следующие команды, начиная со строки (7) в примере N 3:
(7) int 20h (8) int 20h (9) My_name db ‘Oleg$’ (10) CSEG ends (11) end _start
Просто продублируем команду int 20h (хотя, как вы уже знаете, до строки (8) программа не дойдет).
Теперь ассемблируйте программу заново. Запускайте ее под отладчиком. Вы увидите, что в DX загружается не 109h, а другое число. Подумайте, почему так происходит. Это просто!
В окне «Memory» («Память») вы должны увидеть примерно такое:
1234:0000 CD 20 00 A0 00 9A F0 FE = .a. |N1_|_N2_| |_________N3__________| |N4_|
Позиция N1 (1234) — сегмент, в который загрузилась наша программа (может быть любым).
Позиция N2 (0000) — смещение в данном сегменте (сегмент и смещение отделяются двоеточием (:)).
Позиция N3 (CD 20 00 . F0 FE) — код в шестнадцатеричной системе, который располагается с адреса 1234:0000.
Позиция N4 (= .a.) — код в ASCII (ниже рассмотрим), соответствующий шестнадцатеричным числам с правой стороны.
В Позиции N2 (смещение) введите значение, которое находится в регистре DX после выполнения строки (5). После этого в Позиции N4 вы увидите строку «Oleg$», а в Позиции N3 — код символов «Oleg$» в шестнадцатеричной системе. Вот что загружается в DX! Это не что иное, как АДРЕС (смещенеие) нашей строки в сегменте!
Но вернемся. Итак, мы загрузили в DX адрес строки в сегменте, который мы назвали CSEG (строки (1) и (9) в Прмере N 3). Теперь переходим к следующей команде: int 21h. Вызываем прерывание DOS с функцией 9 (mov ah,9) и адресом строки в DX (mov dx,offset My_name).
Как я уже говорил раньше, для использования прерываний в программах, в AH заносится номер функции. Номера функций нужно запоминать.
Наше первое прерывание.
Функция 09h прерывания 21h выводит строку на экран, адрес которой указан в регистре DX.
Вообще, любая строка, состоящая из ASCII символов, называется ASCII-строка. ASCII символы — это символы от 0 до 255 в DOS, куда входят буквы русского и латинского алфавитов, цифры, знаки препинания и пр.
Изобразим это в таблице (так всегда теперь будем делать):
Функция 09h прерывания 21h — вывод строки символов на экран в текущую позицию курсора:
Вход: AH = 09h, DX = адрес ASCII-строки символов, заканчивающийся ‘$’
Выход: ничего
В поле «Вход» мы указываем, в какие регистры что загружать, а в поле «Выход» — что возвращает функция. Сравните эту таблицу с Примером N 3.
Вот мы и рассмотрели сегментацию памяти. Если я что-то упустил, то это рассмотрим в последующих выпусках. Очень надеюсь на то, что вы разобрались в данной теме.
Теперь интересная программка для практики, которая выводит в верхний левый угол экрана веселую рожицу на синем фоне:
(1) CSEG segment (2) org 100h (3) _beg: (4) mov ax,0B800h (5) mov es,ax (6) mov di,0 (7) (8) mov ah,31 (9) mov al,1 (10) mov es:[di],ax (11) (12) mov ah,10h (13) int 16h (14) (15) int 20h (16) (17) CSEG ends (18) end _beg
Многие операторы вы уже знаете. Поэтому я буду объяснять только новые.
В данном примере мы используем вывод символа прямым отображением в видеобуфер.
В строках (4) и (5) загружаем в сегментный регистр ES число 0B800h, которое соответствует сегменту дисплея в текстовом режиме (запомните его!). В строке (6) загружаем в регистр DI нуль. Это будет смещение относительно сегмента 0B800h. В строках (8) и (9) в регистр AH заносится атрибут символа (31 — ярко-белый символ на синем фоне) и в AL — ASCII-код символа (01 — это рожица) соответственно.
В строке (10) заносим по адресу 0B800:0000h (т.е. первый символ в первой строке дисплея — верхний левый угол) атрибут и ASCII-код символа (31 и 01 соответственно) (сможете разобраться?).
Обратите внимание на запись регистров в строке (10). Скобки ( [ ] ) указывают на то, что надо загрузить число не в регистр, а по адресу, который содержится в регистре (в данном случае, как уже отмечалось, — это 0B800:0000h).
Можете поэксперементировать с данным примером. Только не меняйте строки (4) и (5). Сегментный регистр должен быть ES (можно, конечно, и DS, но тогда надо быть осторожным). Более подробно данный метод рассмотрим позже. Сейчас нам из него нужно понять принцип сегментации на практике.
Следует отметить, что вывод символа прямым отображением в видеобуфер является самым быстрым. Выполнение команды в строке (10) занимает 3 — 5 тактов. Т.о. на Pentium-100Mhz можно за секунду вывести 20 миллионов(!) символов или чуть меньше точек на экран! Если бы все программисты (а особенно Microsoft) выводили бы символы или точки на экран методом прямого отображения в видеобуфер на Ассемблере, то программы бы работали чрезвычайно быстро. Я думаю, вы представляете.
Источник: codenet.ru
Битовые операции